阅读流 / 转给朋友
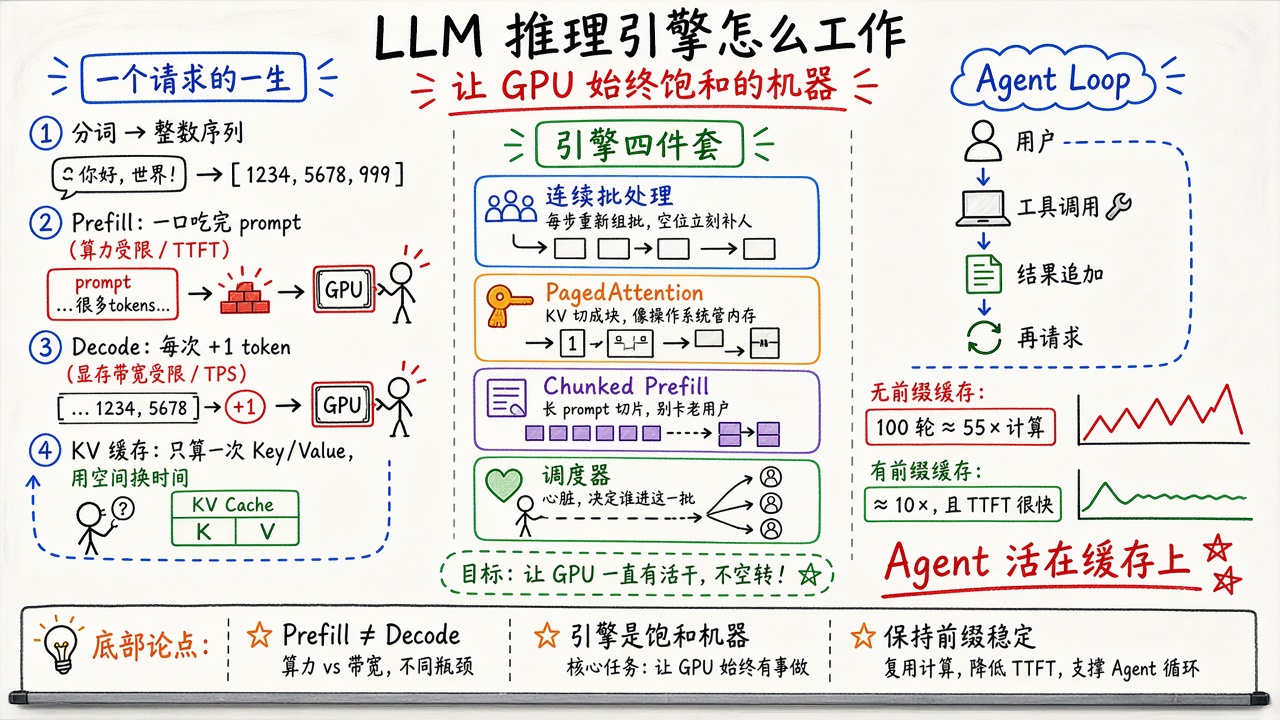
LLM 推理引擎到底是怎么工作的:从一个 token 到 KV 缓存、连续批处理,再到 Agent Loop 如何把 GPU 榨干
复制链接,或直接分享到 X / Threads。
选择接收方式,再决定你真正想看的内容。
新一期编好后发送;周刊邮件中可切换语言或退订。
RSS 不需要邮箱。选择内容后,可以复制 Feed,或一次导出为 OPML。
ursb.me/reading/weekly/feed.xml
ursb.me/blog/feed.xml
ursb.me/reading/feed.xml
ursb.me/notes/feed.xml