Jev 不写长回答,怎样做出一个判断?
理解它要分清四件事:预先约束的答案空间、并行判断、概率校准,以及最终仍由程序承担的业务规则。
同一份输入,三种判断
同一输入,三种输出|Choice 选类别,Score 在给定刻度上评分,Noul 判断命题。图中的选项概率、Score 和 confidence 含义不同,不能都读成“回答正确率”。这是 LangChain 作者的示例输出,本刊未复测该工单。
Sydney Runkle、Hunter Lovell / LangChain,Building a harness with Jev,三种 decision primitives 原图。原图直接保存,未重绘。 ↗输入材料,先定义软件需要什么答案
腾讯云开发者的原文把 Jev 放进模型职能分化的脉络。落实到官方 API,调用者发送 model、state 和 questions:state 可以是文本、对象或数组,questions 写明问题、类型与判断标准,返回值按问题 ID 对应。这个 ID 只是程序索引,模型并不读取它;把字段命名成 urgent,并不能替代对“紧急”的完整定义。API 文档
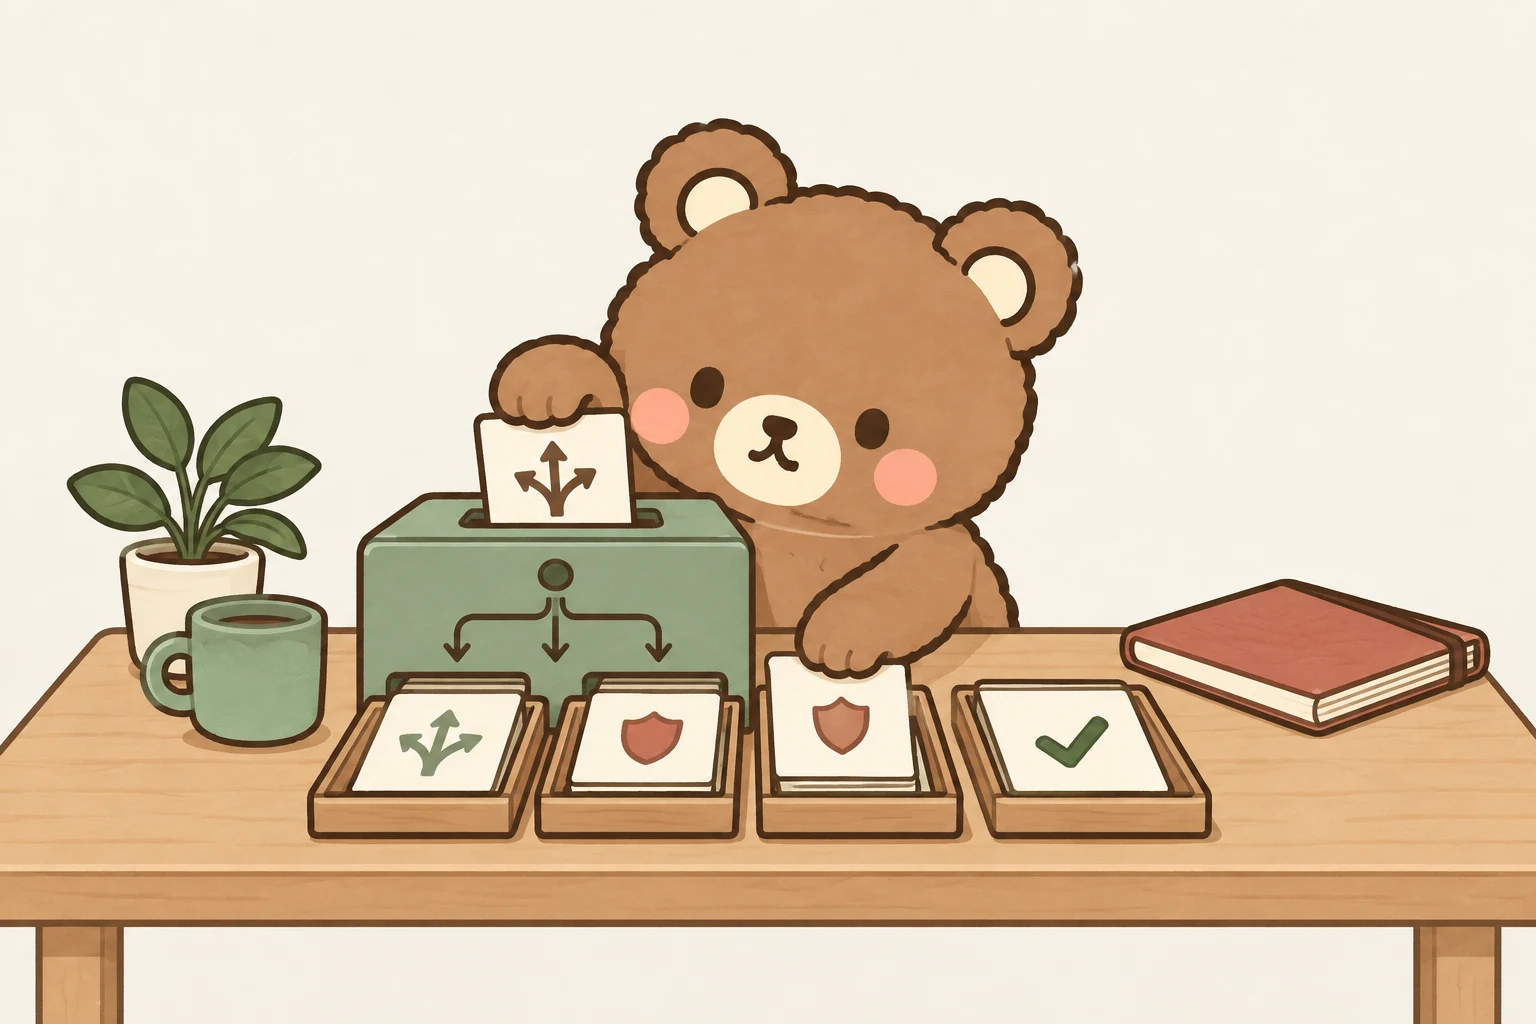
三种原语对应三种业务需要。Choice 在给定选项中选一个,例如工单归属;Noul 返回命题成立的概率,0.5 表示犹疑而非“中等紧急”;Score 用文字定义有序等级,再返回等级位置及分布。官方示例中,等级 1、2 的概率为 0.57、0.43,分数是 1×0.57+2×0.43=1.43,它不是故障影响了 43% 的用户。Noul、Score
速度来自输出方式,也来自任务拆法
TypeSafe 公开的设计是让所有问题共享同一份 state,独立、并行地产生结构化结果,省去自由文本逐 token 输出。这里的“独立”尤其关键:一个问题的答案不会自动成为另一个问题的前提。需要跨步骤推导时,开发者仍要在代码中安排依赖,或交给有相应能力的生成模型。官方介绍
官方把一种用法称为推测式展开:处理工单时,一次询问类别、故障严重性、是否要求退款。若类别是功能建议,程序丢弃故障和退款判断;若是故障,则立即已有严重性可用,省掉第二轮网络往返。收益来自少发重复材料、少等待串行请求;问题之间没有真正依赖,才适合这样并行。工作流示例
RLCD 校准什么,confidence 又是什么
RLCD 全称是“面向校准决策的强化学习”。官方公开的是训练目标:输出决策与概率,使一批被赋予 0.8 概率的事件,发生频率接近八成。这描述一组预测的统计表现,不能证明眼前这一条必然正确。所读官方材料没有给出可复现的网络结构和完整损失公式,因此不能进一步断言它就是某种 Encoder、参数规模多大,或采用了某个特定校准损失。AI primer
另一个容易混淆的字段是 confidence。Choice、Score 的 confidence 来自概率分布的集中程度;它概括模型有多犹疑,并不等于该次答案正确的概率。Noul 没有额外的 confidence 字段。我的建议是保留完整分布与人工标注对照:模型总是非常笃定,也可能只是把某类案例稳定地分错。Confidence
用工单系统检验它是否真正有用
可以据此设计一个客服流程:订单状态交给确定的查询函数,产品疑问带知识库交给生成模型,复杂投诉送人工;Jev 提供意图、紧迫性与相关性信号,代码决定权重和去向。这是编辑提出的试点方案。衡量时应看人工队列减少多少、错误路由带来多少返工,而不只看一次调用多快。
截至本次核读,官方模型页列出的输入价为每百万 token 0.042 美元,输出免费;发布文章称端到端约 70–500ms,并说明延迟评估通常来自美国西海岸。这些是厂商定价与测试口径,不能直接充当本地业务的实测收益。类型约束能够排除选项外的输出,语义判断仍可能出错;原文的“不会写代码”恰好提示了适用范围:把高频判断做成受约束的零件。模型页、发布说明
原理图解 · 同一份材料,三种独立问题