← Airing 的阅读流第 002 期English ↗
NO. 0022026.09.27—10.03

AI 趋势周刊

每周一更新 · 理解正在发生的变化

小熊在编辑台制作影片,胶片穿过水彩、纸雕与几何风格的场景;AI 概念插画

封面专题 · 代码与影像

Opus 5.5

把代码
拍成电影

导演方案 · 风格文档 · 时间轴 · 逐帧渲染
小熊编辑台 · AI 概念插画

Agent 工程Pi 1.0,两条 Agent 路线

工具上新10 款工具,短读速览

AIRING’S READING DESK

002

创作在提速,
判断更不能省。

从代码生成影片,到更省上下文的 Agent 运行方式,本期追踪的是:更快、更便宜的能力,怎样变成可控的工作流。

本期编辑
Airing ↗
本期范围
2026.09.27 — 2026.10.03
出版日期
2026.10.05 每周一更新
本期收录
45 篇阅读 · 5 个主题6 篇专题 · 10 款工具 · 13 则短读

本期导读

代码怎样变成影片?Agent 怎样少带包袱、多留证据?哪些新品值得顺手试一试?这一期,详略跟着问题走。

取材于 Airing 的阅读流
原文、图像出处与补充资料随文附上。

01

代码拍电影

制作流程 · 风格样片 · 创作短读

封面专题

Opus 5.5,把代码拍成电影

这不是把一句提示词交给视频模型,而是让 Opus 写动画、浏览器画帧、剪辑工具合成。它真正改变的,是影片可以怎样修改。

01 / 代码为什么能变成影片?

Lemo 的 lemo-opuscar 把制作分成三层:模型负责写 Canvas / WebGL 动画;浏览器按指定时间绘制画面;FFmpeg 再把帧序列和声音、字幕合成文件。它生成的是“怎样画这一帧”的程序,走的不是视频扩散模型那条路线。

区别会在修改时显现:想把标题晚放半秒,修改出现时间;想让镜头慢一点,修改运动曲线;想换一个数据,修改图形参数。内容与时间仍在代码里,因而可以逐项检查。代价也在这里:镜头越依赖人物表演、自然动作和连续写实场景,越不能从几段风格样片推断最终效果。图形讲解、品牌动效和风格化短片,是更直接的起点。

01 / PRODUCTION
一个导演方案, 三路素材, 同一时间轴
小熊在剪辑台上把影片胶片、波形纸条和字幕纸条按共同切点排到一起;编者概念插画。

小熊剪辑台 · 编者概念插画。画面、声音、字幕沿共同切点组织;具体制作步骤见旁边的说明。

故事 · 风格 · 镜头与节拍先确定要让观众理解什么变化
PICTURE
动画程序
Canvas / WebGL → render(t)

浏览器按时间取帧;标题、运动和参数可改。

SOUND
旁白 · 音乐 · 音效
声轨 + cue 时间点

台词与动作共用节拍,避免各自计时。

TEXT
字幕与标题
文字 + 出现 / 停留时间

内容和读完所需时间,都在方案里确认。

FFmpeg逐帧画面 + 混音 + 字幕 → 成片

编者根据 DIRECTOR / TECHNIQUE 绘制。三路素材共用时间点,修改才有明确的落点。

02 / 风格不是换一层滤镜

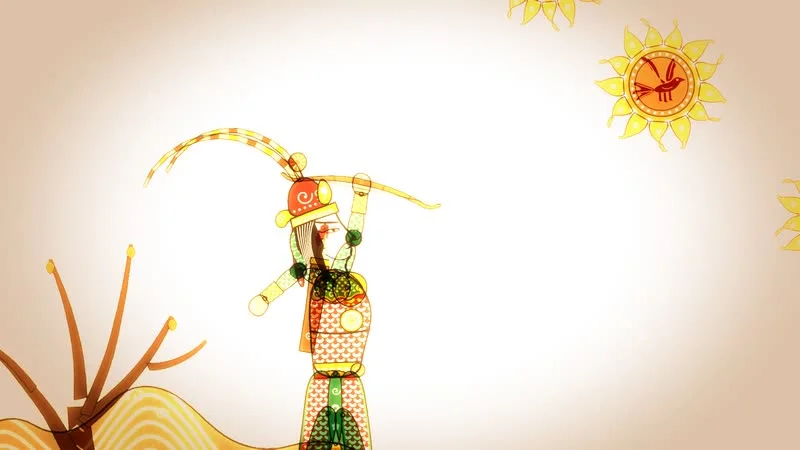
每种 STYLE 文档不仅描述配色和材质,也规定动作与转场。白板讲解用笔画出现的顺序解释概念;皮影戏要服从关节和幕布的运动;瑞士平面动效让网格、字形与节拍承担叙事。风格选错,技术完成了,内容也可能更难懂。

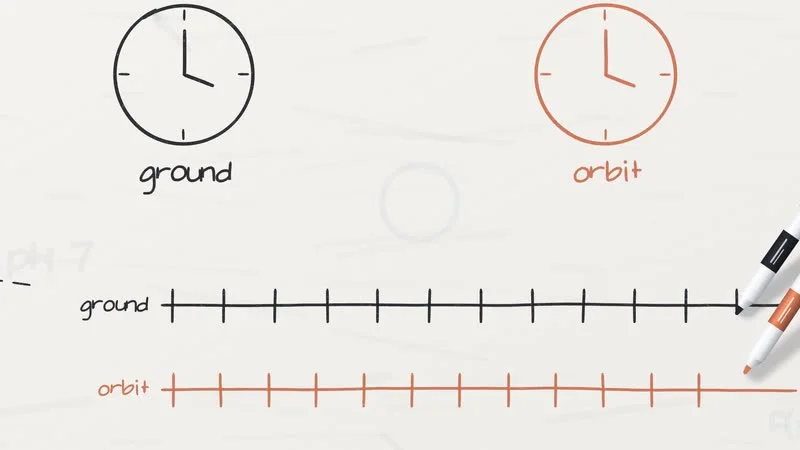
看原项目的白板样片:它用地面与卫星上的两只钟解释 GPS 的相对论校正,公式和笔画随讲解出现。这里的作用是建立因果关系。瑞士动效更适合强调结构和节奏,皮影则让灯光与角色运动成为故事线索。做个人讲解时,应先问“读者需要看到什么变化”,再决定借哪一种视觉语法。

Lemo 白板样片中并排的时钟与讲解用标记

WHITEBOARD

两个钟,把抽象差异变成对照

先建立可比较的对象,再让笔画、公式与旁白同步出现。画面承担解释,而不是填补空白。

读风格文档 ↗
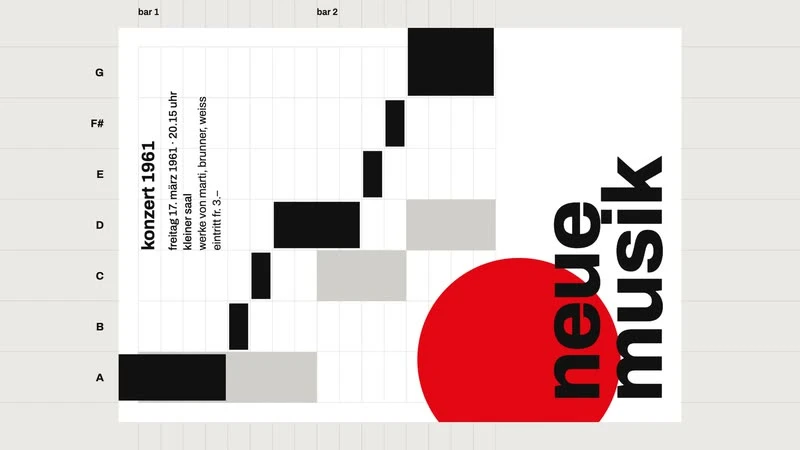
瑞士平面动效 · Lemo lemo-opuscar
瑞士平面动效
网格 × 字形 × 节拍

结构随节拍重组,适合把规则、比例和例外做成视觉节奏。

STYLE.md ↗
皮影戏 · Lemo lemo-opuscar
皮影戏
关节 × 幕布 × 灯光

运动要服从偶的结构;灯光变化本身可以成为故事线索。

STYLE.md ↗
水彩笔刷 · Lemo lemo-opuscar
水彩笔刷
落笔 × 晕染 × 留白

材质变化承担过渡,更适合氛围与意象;信息不能淹没在纹理里。

STYLE.md ↗
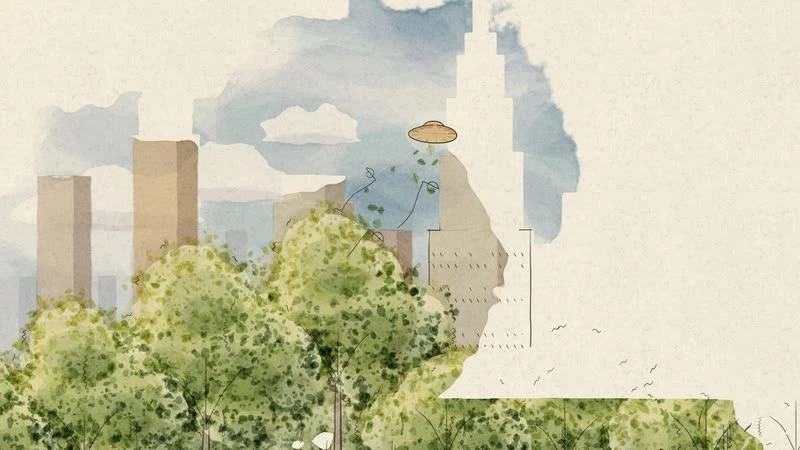
都市速写 · Lemo lemo-opuscar
都市速写
线稿 × 色块 × 街景

依次出现的线条与色块,让观众跟着视线发现一个地方。

STYLE.md ↗

原项目画面:Lemo / lemo-opuscar,固定版本 c4bc370。点击画面可放大;封面小熊是本刊单独生成的概念插画。

03 / 45 秒影片,先把分镜和声音排到一起

下面用“Agent 怎样整理上下文”做一个编者分镜:前 3 秒提出问题,随后让日志堆上工作台;中段把完整日志归档,只留下摘要和可召回的句柄;最后用一次回看原文收束。不是四张图配四句话,而是每一段动作都对应一个理解上的变化。

动画由 render(t) 取指定时刻的画面,旁白、字幕和音效使用同一组时间点。渲染不能依赖电脑当时跑得快不快,也不能让实时随机数改掉画面。45 秒、24 fps 对应 1,080 帧,这是按项目默认帧率计算的帧数,不是性能成绩。如果旁白从 12 秒改成 14 秒,后续字幕和动作也要随同一时间轴移动,不能各自补丁。

02 / STORYBOARD
45 秒,四个理解上的变化
编者分镜示例 · 不是原项目成片
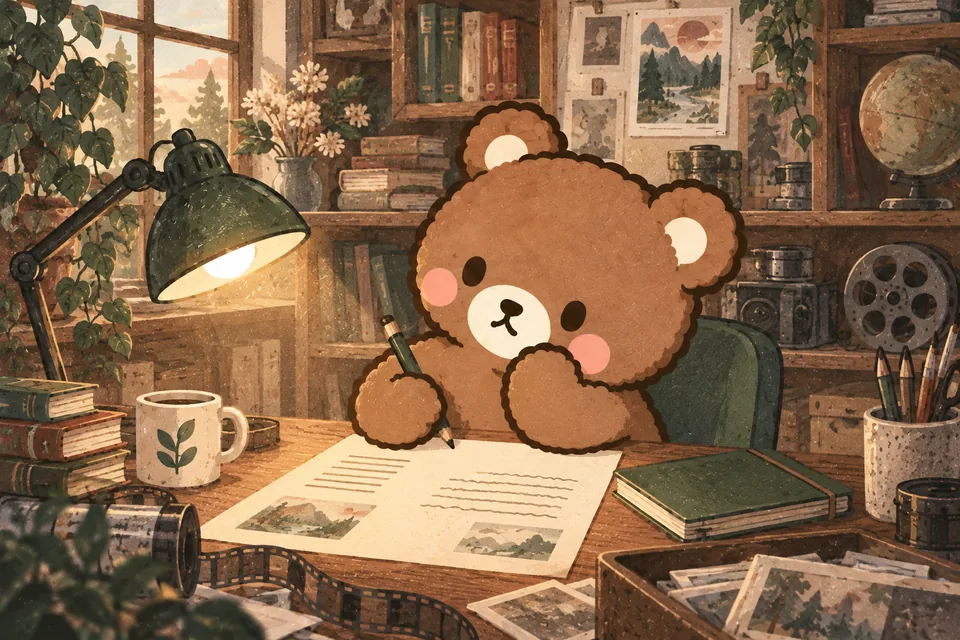
  1. 小熊在编辑台前握着铅笔思考,面前只有一张纸和一本绿色笔记本;编者概念插画。
    01
    00–03s
    提出问题

    “为什么越做越乱?”

    先让观众看见一次犹豫,再提出上下文的问题。

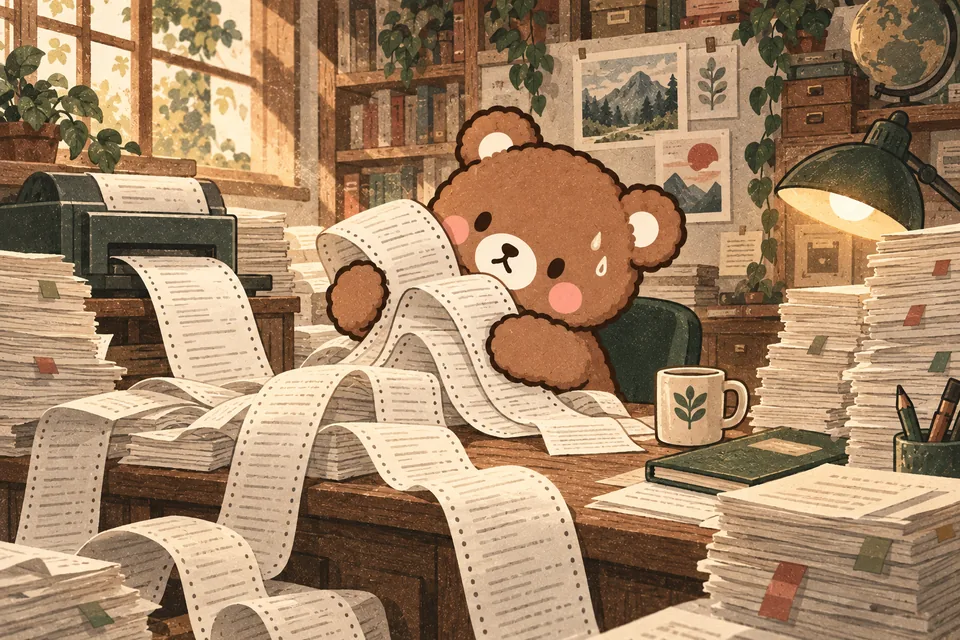
  2. 连续日志纸卷和重复的纸堆挤满工作台,小熊努力抱住越来越多的纸;编者概念插画。
    02
    03–15s
    看见负担

    “每轮都带上同一份日志。”

    重复的纸卷挤满桌面,把反复输入变成看得见的负担。

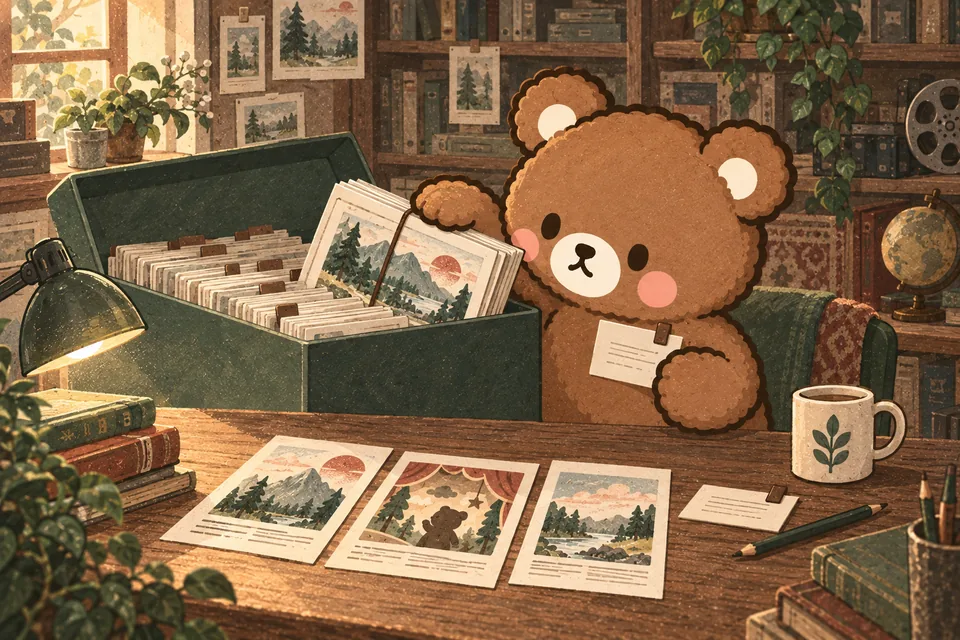
  3. 小熊把完整资料放入绿色档案盒,手里保留一张索引卡,桌上只有几张需要的资料;编者概念插画。
    03
    15–32s
    分开存与读

    “完整存,只读当前需要的。”

    整份资料进入档案,工作台只留下索引和当前需要的页。

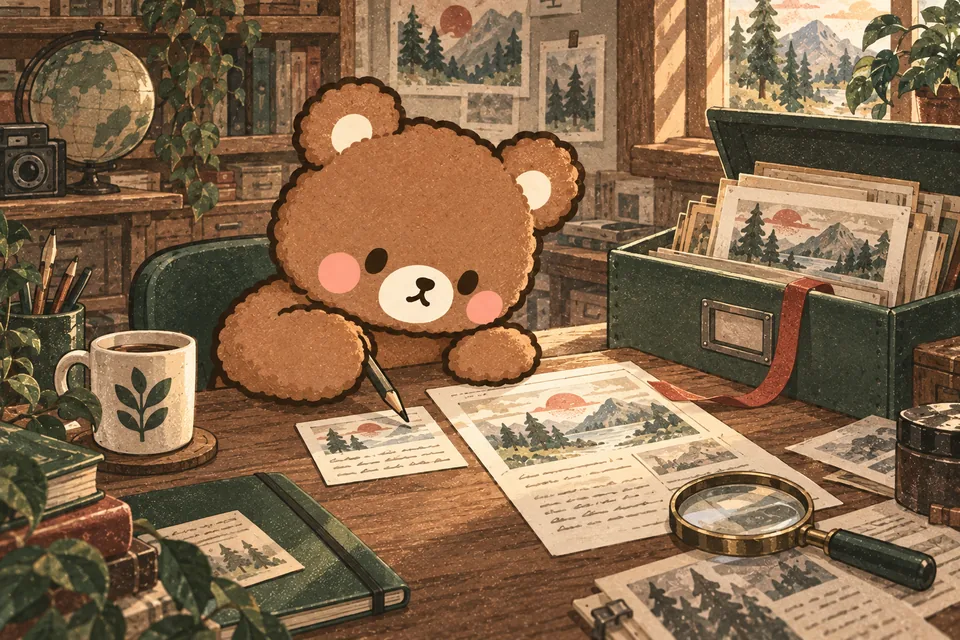
  4. 小熊用铅笔对照小摘要卡和档案中取出的原始资料,旁边放着放大镜;编者概念插画。
    04
    32–45s
    回到证据

    “需要时,再回到原始证据。”

    把摘要与取回的原文放在一起,核对同一处信息。

小熊分镜 · AI 概念插画。四张图是静态故事板,说明镜头要表达什么;不代表 Opus 已生成这段动画。

共享时钟
0s15s30s45s
画面
01020304
旁白
01020304
字幕
01020304
一次修改怎样传递?

第 02 段旁白变长 → 把第 03 段起点后移 → 同步调整画面、字幕与音效 cue → 重新渲染与合成。

分镜等宽方便比较,轨道按时长比例绘制。帧数为编者计算:45s × 24 fps = 1,080帧。不代表生成速度。

04 / 制作流程,把“再改一版”变得具体

DIRECTOR 先约束一个主题、一个目标和一个转折,再形成镜头与声音方案;TECHNIQUE 处理逐帧渲染和音画合成;STYLE 给出具体表现方法。创作者可以分别确认“故事讲什么”“画面长什么样”“节拍是否合适”,不必等完整影片生成后才发现方向错了。

审阅也应分两遍:先看联系表,找构图重复、关键动作遗漏与镜头跳变;再带声音完整观看,听旁白是否挤、字幕是否读得完、音效是否抢了重点。代码容易修改,不等于成片自动成立。收藏标题保留当时的 39 种风格,本稿核查的仓库版本已列出 43 种;数量之外,更该检查可运行代码、素材授权和你自己的实际试片。
创作短读 / 把视线放回作品

集邮册动效:把一个动作做完整

翻页、落章、再翻页。这个案例的价值在动作之间的节奏与材质衔接,适合当作 UI 和品牌动效的观察样本,不必套一个宏大的 AI 结论。

15 秒艺术史:看表达,也看压缩的代价

作者展示 Fable 5.5 的艺术史动画,适合观察视觉过渡和风格连贯性。把四万年压进十几秒,是创意概括;历史准确性、制作耗时与可复现程度不能仅从成片推断。

技术变快,创意的判断仍要留下

Katzenberg 的观点把讨论拉回想象力、情感和创作者报酬。和封面专题一起看,值得问的是:当出片更容易,故事、选择与合作条款能不能同步变好?

02

Agent 的工作台

上下文 · Pi 1.0 · Mods

深入阅读 / 01

上下文瘦了,证据不能丢

Pi 把档案与工作台分开,SoL-Pi 再压缩重复信息。但一张更便宜的账单,可能也对应更少的成功任务。

01 / 完整历史,不必每轮都搬上桌

假设 Agent 读过一份 2,000 行的构建日志。下一轮只是决定改哪个文件,却又收到整份日志;之后还要验证修改,整份日志继续留在输入里。问题不只是日志长,而是同一份观察结果反复进入后续判断。下面的行数是编者示例,不是测得的 token 占用。

Pi 社区文章区分 Session History 与 Context:前者保留事件,后者是模型当前看到的投影。SoL-Pi 的 ObservationPack 则把大输出留在本地档案,用稳定句柄、短摘录和按页召回替代整块文本。正确的取舍是完整保存、选择呈现。只写“构建失败”会丢掉文件位置和错误原因;保留句柄、关键行和下一步目标,才让摘要可以被核验。

03 / CONTEXT
完整的记录,可以有精简的入口
编者示例 · 2,000 行日志 · 形状示意,不代表 token 测量
BEFORE
每轮带上完整结果
build.log0001 … 2000
下一次判断0001 … 2000
再一次验证0001 … 2000

档案、当前目标与观察结果混在同一输入里。

AFTER
档案保留,桌面按需呈现
完整日志 / 本地档案build.log · 0001 … 2000
模型当前看到的内容
句柄
log:build/184
关键行
317–322 · 错误位置
下一步
修改对应文件后验证

需要更多证据 → 按句柄取回对应原文。

句柄和行号为示例;具体召回接口依扩展而定。省下的是重复输入,原始证据仍在档案中。

02 / 少一轮对话,不等于少做一步验证

Codemode 让模型写一段 JavaScript,在 QuickJS 沙箱里编排工具、筛选结果,再显式返回必要信息。例如“找日志 → 过滤错误 → 读取相关片段”,可以在一段编排中完成,模型最后读一份紧凑结果。没有中间判断需要的读操作适合合并;需要看上一项结果再决定是否写入的操作,不宜为了少一次调用硬拼。

这个沙箱没有 Node、任意文件访问或网络,能力来自显式开放的工具。沙箱本身失败,也不会撤销外部工具已经完成的写入或发送。另一个容易漏算的账是缓存:压缩会重写输入前缀,可能增加当轮重写与后续缓存重建的费用。只有未来多轮省下的费用覆盖这笔开销,压缩才真的回本。

03 / 总费用低了,成功任务的分母呢?

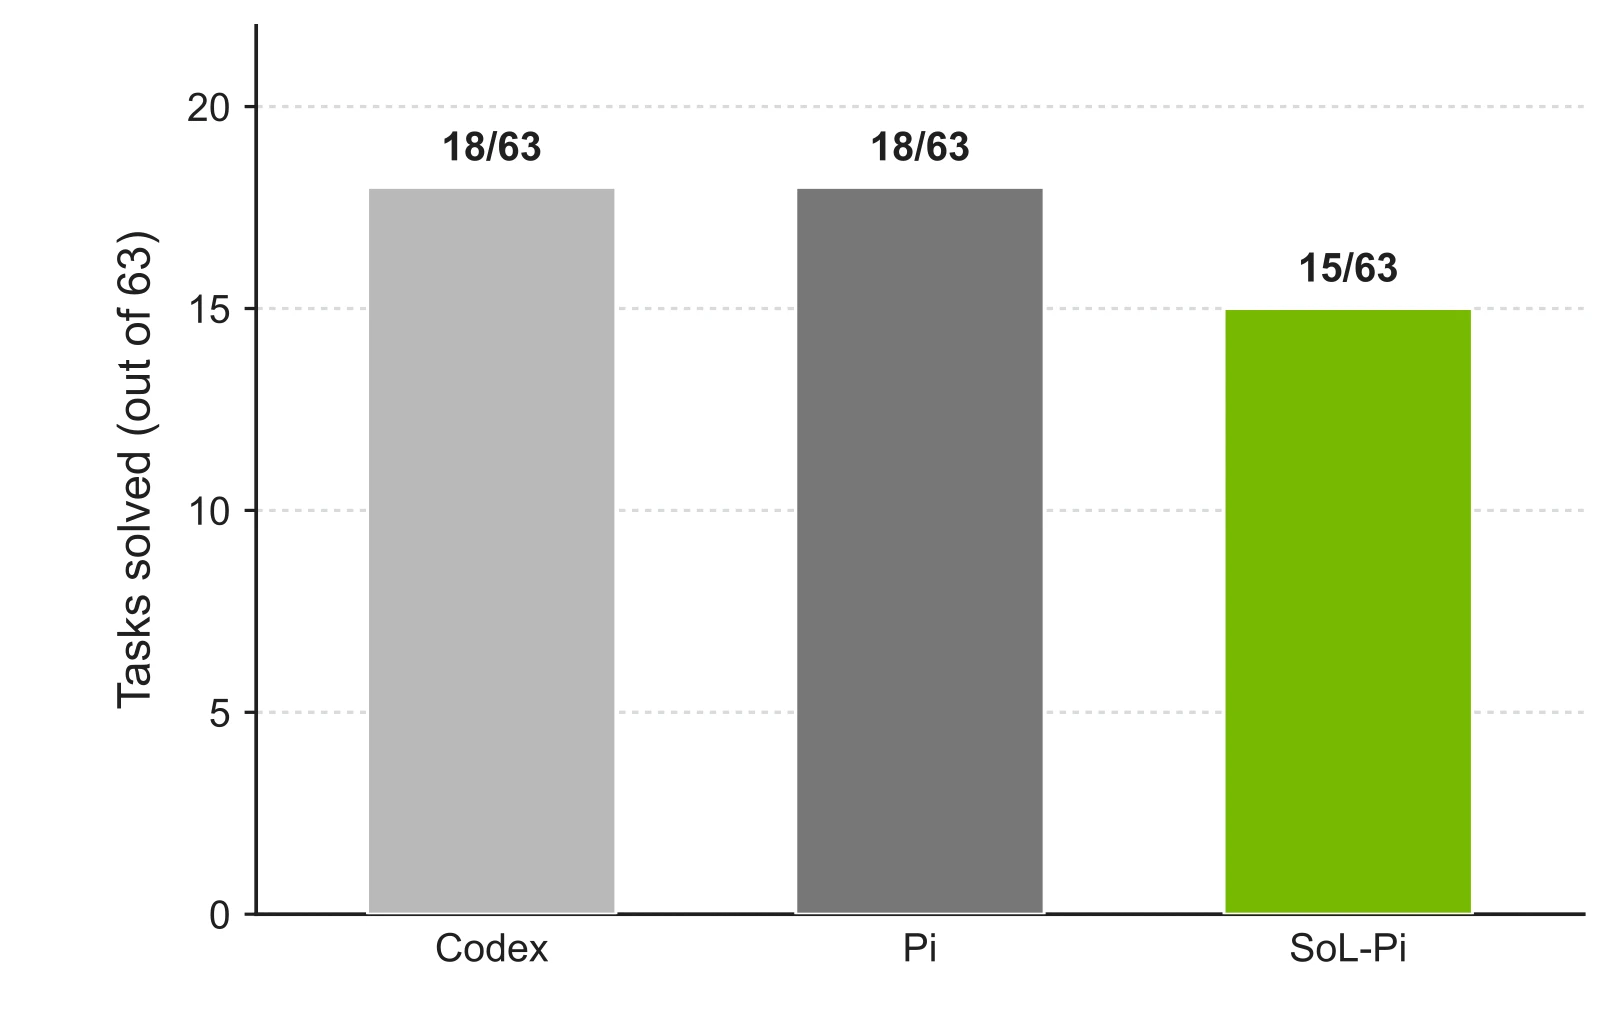
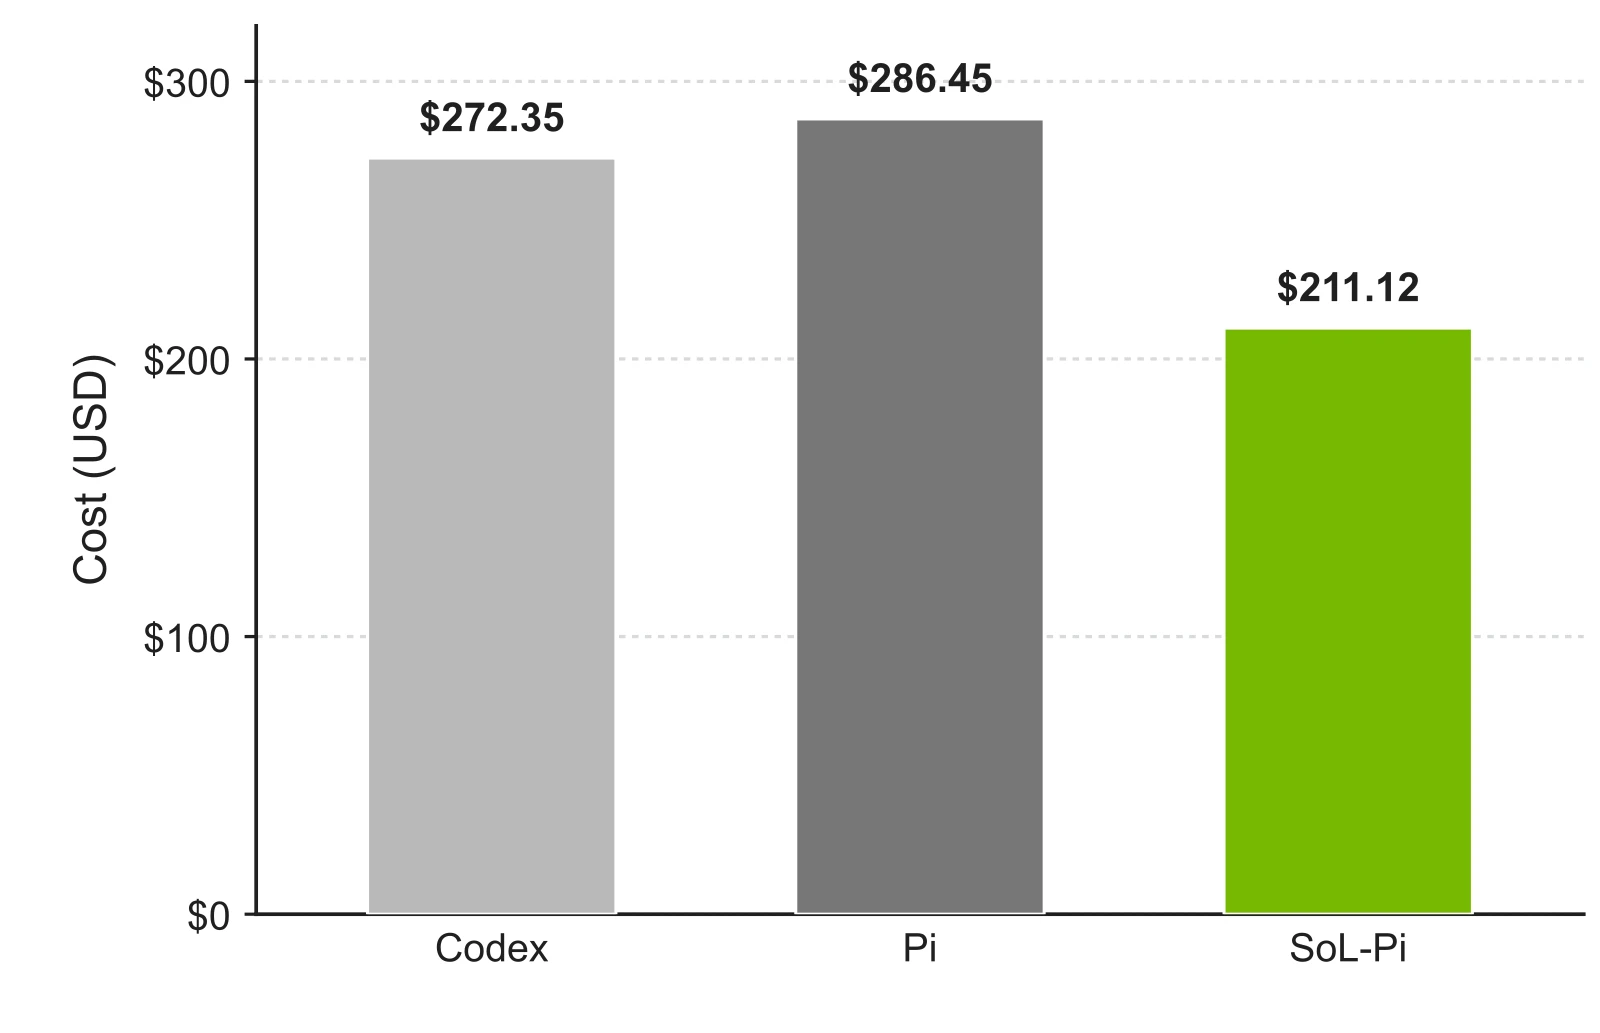
SoL-Pi 还提供 ActionFusion、证据保留式日志压缩和在线上下文整理,四项机制默认关闭,强调可选与可验证。它的官方 TerminalBench 4 对比包含 63 道 CPU-only 任务:Pi 解出 18 道,SoL-Pi 解出 15 道;总 API 等价费用分别为 286.45 与 211.12 美元。

按这组结果,总费用下降约 26.3%,但解出的任务也少了 3 道。编者把总费用除以解题数,摊销到每个成功任务,约为 15.91 与 14.07 美元,下降约 11.6%。这仍没有控制题目难度,不能解释为每道题都便宜了 11.6%。这张账单更适合提醒我们:必须把费用与完成情况一起读。先用 /context 找出占用,再用自己的任务检查证据能否召回、错误能否定位,最后决定开哪些压缩机制。

完成情况 / 63 道题里解出多少
放大查看 ↗
完成情况 / 63 道题里解出多少

原图包含 Codex、Pi 与 SoL-Pi。本稿下面的摊销只比较 Pi 与 SoL-Pi,不把两个不同基线混在一起。

图像来源:NVlabs · SoL-Pi ↗
总费用 / 同组任务的 API 等价账单
放大查看 ↗
总费用 / 同组任务的 API 等价账单

费用单位:美元;这是整组任务的总费用,包含没有解出的尝试,并非一次成功请求的单价。

图像来源:NVlabs · SoL-Pi ↗
编者计算 / 同一任务组
账单降了 26.3%,摊销到成功任务呢?
框架总费用解出题数费用 ÷ 解题数
Pi$286.4518 / 63$15.91
SoL-Pi$211.1215 / 63$14.07
−11.6%每个成功任务的摊销费用

完成数同时少了 3 道。摊销包括失败尝试,未控制题目难度;不能理解为每一道题都省了这个比例。

TerminalBench 4 · 63 CPU-only 任务 · USD · NVlabs ↗

深入阅读 / 02

Pi Agent 1.0:极简助手,长任务新路

Pi 1.0 延续终端里的极简交互,实验性的 Pi Durable 探索长任务恢复。沿着这次发布,看 Agent 怎样兼顾轻与稳。

01 / 同一天发布,先看清两条路线

10 月 1 日,Pi Agent 1.0 正式发布。它仍是由一个人在终端里驱动的编码助手;同日发布的 Pi Durable 则是面向长任务与多个客户端的独立实验框架。两者共享底层模型接口与极简理念,服务于不同的使用方式。

这一周的变化要连着看:9 月 29 日的 0.99 已加入 MCP、Codemode 与虚拟模型;1.0 继续精简提示、改善终端体验并加固工具认证。官方演示把 Claude 的规划、Jev 的判断与 GPT 的执行串进同一场会话。编者认为,这次发布值得关注的,是让使用者自己定义工作流的空间。

RELEASE / 2026.10.01
同一天发布,两个落点
PI CODING AGENT / 1.0
人在终端里,直接带着它做事

写代码、调工具;人可以检查中断位置,再继续。

1.0 更新:默认全屏、精简 Codemode 提示、脚本内生图、MCP OAuth 加固。

PI DURABLE / EXPERIMENTAL
任务跑得久,进度也留得住

为长任务与多个客户端构建应用;保存检查点,恢复未完成任务。

这是独立实验包。工具重跑需要明确策略;子 Agent 由应用组合。

编者按官方说明整理。两条路线共享底层能力;Durable 的实验状态和恢复策略要单独评估。 发布说明 ↗ · Pi Durable ↗

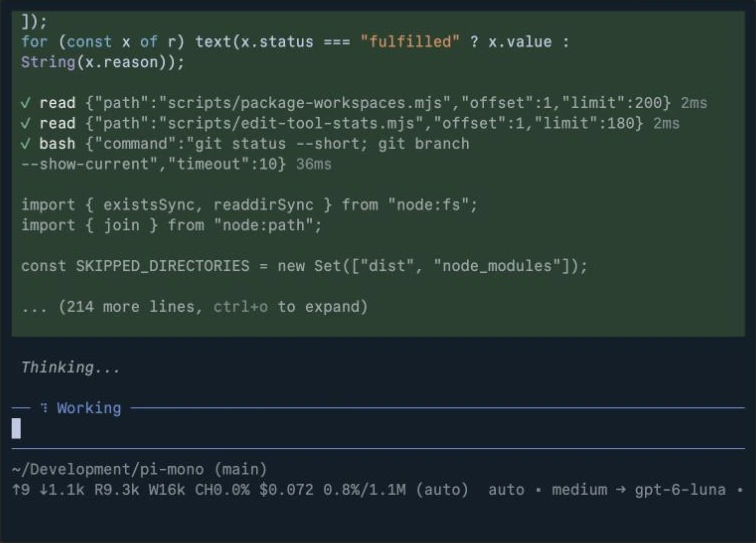
官方演示 / 自定义 router 已切到执行模型
放大查看 ↗
官方演示 / 自定义 router 已切到执行模型

Pi 1.0 官方终端录制,约 1 分 32 秒:底栏已显示 gpt-6-luna。完整演示用自定义 router/auto 扩展串起 Claude 规划、Jev 判断与 GPT 执行;这不是默认自动路由,也不是 Durable 的恢复演示。

图像来源:Earendil · Pi 1.0 ↗

02 / 崩溃前发出的邮件,可能已经发出去了

一个具体断点:Agent 写好报告、请求发邮件,邮件服务已经接受请求;进程却在保存回执之前退出。重启后,本地只有“准备发送”,没有“已发成功”。此时直接重跑会重复发送,把它当作未完成跳过又可能丢掉后续工作。真正缺的不是一段对话,而是动作结果的确认。

Pi Durable 在每一步留下检查点,重启后从未完成任务的检查点继续。模型请求可以重新发起;被中断的工具调用,只有明确声明可安全重跑时才会重跑,否则向模型报告中断。但外部副作用有另一条时间线:恢复时必须区分已提交、确认未执行和结果不明。前两种能制定明确策略,第三种要向外部服务查状态,或依据同一个幂等键确认,不能把“无回执”理解成“未执行”。

04 / RECOVERY
邮件已被接受, 回执却没来得及存
编者故障示例 · 不代表 Pi 的默认发送策略
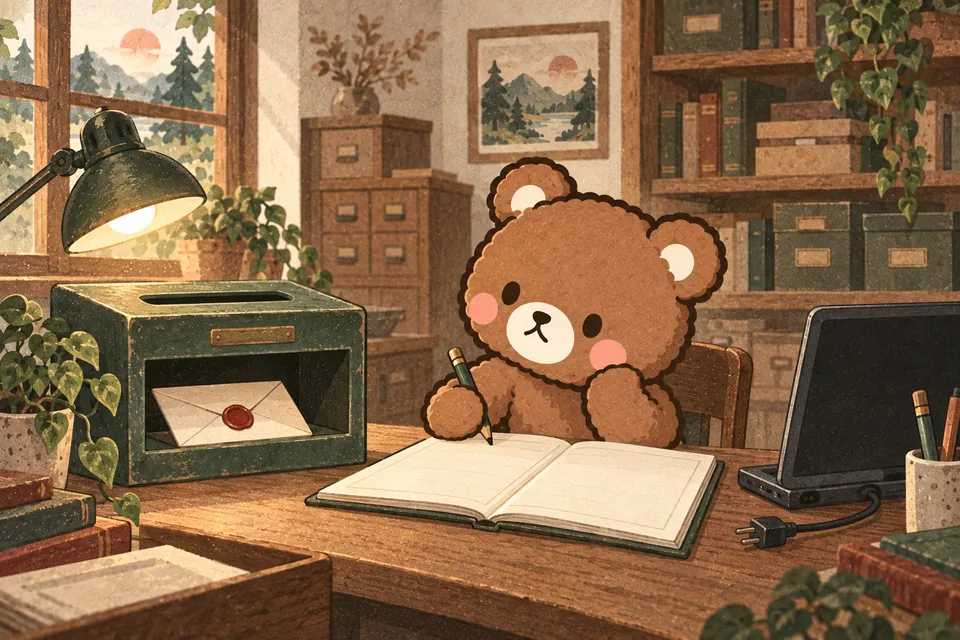
信封已经进入投递箱,回执簿仍然空白,断电电脑前的小熊停下核查;编者故障场景插画。

信封已在投递箱里,回执簿仍是空白。插画用两个物件表现外部动作与本地记录之间的空隙。

  1. 01记录发送意图本地有记录
  2. 02服务接受请求副作用可能已发生
  3. ×进程中断回执尚未提交
重启后:查的是状态,不是猜答案不能从“无回执”推断“没发送”
✓
已确认完成

读取已提交结果,继续下一个步骤。

○
确认未执行

按策略重新安排,不重做已完成部分。

?
结果不明

查服务端状态 / 幂等键;确认后才决定重试。

对话持久化保存进度;外部动作是否发生,仍需外部确认。

03 / 并行需要归属,恢复需要顺序

让多个 Agent 同时研究不同资料,可以加快独立任务;它们共同修改一个结果时,合并顺序、取消传播和重复执行就成了问题。Pi Durable 没有内置子 Agent;应用可以用独立会话组合它们,并记录会话的归属。归属于父工具调用的子会话,会在父调用中止时收到取消。关键是记清谁在等待谁、哪些结果已提交。

以报告任务为例:检索与画图可以并行;发送应该等待正文和附件都确认。恢复后先读取已提交的结果,再重新安排确认未运行的子任务,把不明状态留给核查。编者建议把“完成了哪些步骤”和“产生了哪些外部动作”分开记录,这样一次局部中断就不必变成全流程重放。

04 / 升级值得看,兼容仍要验

本周收藏里的 Pi 1.0 评论提出扩展冲突、缓存变化和升级兼容的担忧。这些是使用者反馈,不能当作所有环境都会失败的结论。对照官方公告也要把两件事分清:终端助手在继续打磨,Durable 则把更长的任务交给一套独立实验框架。

编者的选型建议是先找真实的恢复点:跨夜研究、等待审批、不能重复提交的操作。若主要是人在终端里边看边改,轻量交互仍有价值;若任务需要无人值守地跨进程继续,就应验证状态与恢复策略。升级时拿已有扩展和一项可中断的真实任务试一遍:哪些结果留下了,下一步为什么不会做两遍。

深入阅读 / 03

Claude Mods,让工作台长出自己的工具

从观察上下文到插入提醒,终端里的 Agent 正在变成可以定制的工作环境。

01 / 把提醒放在错误发生之前

Mods 的入口是事件:工具准备调用、用户输入、界面更新或权限流程发生时,扩展可以观察或参与处理。Token Weather 暴露上下文与费用,Blast Radius 帮助检查影响范围,Replay Theater 回看修改。它们分别回答“已经花了多少”“这次会影响哪里”“刚才发生了什么”,并不是同一种插件换皮。

例如 Agent 准备改一批文件:影响范围视图应出现在执行前,指出目录和预期不符;完成后再给警告就晚了。下面把流程与旁路观察分开画:展示、提醒和干预是不同强度的能力。即使扩展改写了工具参数,既有权限检查也仍要面对实际将执行的动作。

05 / EVENTS
执行链上的检查,旁路中的提醒
  1. 模型提出工具调用准备改哪些文件?
  2. MOD EVENT观察 / 参与处理影响范围是否异常?
  3. 权限边界检查实际动作参数变了也要检查
  4. 工具执行并返回结果留下可审阅的结果
旁路观察
Token Weather / Replay Theater

显示占用与成本,回看修改;它们提供信息。

You should know

指出遗漏要求与对应证据;它提供提醒。

编者结构示意。提醒 ≠ 授权;扩展参与流程,也不等于跳过既有权限。

02 / 一个旁观者,也需要知道何时闭嘴

“You should know”的 sideagent 在旁路检查主会话可能遗漏的事。对长任务,它可以提醒“用户要求保留原文入口,但当前结果删掉了”,前提是提醒能指向明确要求和具体证据。若只是不断重述主模型的话,就增加输入和打断,没有增加判断。

另一条 MW2 大厅案例把等待变成共同体验,属于交互灵感,可以短读保留。两者要分开评估:前者看漏项有没有减少、误报有多少;后者看等待是否更舒适。不要把好玩的界面当成更可靠的执行,也不要让提示变成绕过授权的入口。

工程札记

从写代码,走到负责运行

腾讯云 SRE 实践把基础设施、可观测数据和知识建成关联图谱,并把能力分成只读诊断、授权建议与自动执行。值得借鉴的是渐进放权:先证明能解释故障,再让它参与改变系统。

先定义分工,再组 Agent 团队

这条 Opus 团队案例可以作为搭建入口。真正需要先决定的是角色边界、交接产物与验收条件;任务能够独立验证,团队协作才不会只增加对话。

03

成本与质量

决策分流 · 自动评测

深入阅读 / 01

Jev 怎么分工,才是真的省?

Jev 的五条收藏都在讨论分工:分类、打分与选择,是否每次都需要完整的生成式推理?

01 / 先把开放问题变成可检查的选择

这周五条 Jev 收藏延续了第一期的决策模型:把选择、评分和二元判断从长篇生成中拆出来。收件箱分类、资料相关性、下一步用哪个模型,都有明确候选;写出一份跨资料的解释,则仍需要开放推理。把两类任务混在一起,只看“输出字少所以便宜”,容易忽略决策错一次会带来什么。

拿阅读流举例:新收藏先选“工具新品、机制分析、观点短评”,这是编者示例。产品发布通常可进新品架;一篇同时有新产品和机制拆解的文章,可能需要升级判断;缺少原文的邮件不能因为标题像 AI 就直接成为事实专题。重要的是记录输入证据、选项和选择,而非只留下一个分类标签。

02 / 不确定就升级,高置信也不等于获准

置信度是决策层对自己选择的把握,不是行动许可。分流到“准备发布”仍不代表允许发布;选择删除文件,也不能绕过权限与结果核验。合理的路径是:常规判断交给轻量决策层,模糊、越界和错误代价高的输入升级给强模型或人工,最后用独立条件检查结果。

投入主流程前,可以影子运行:旧流程照常做,新路由只记录建议,与最终人工判断对照。按错误类型统计——把机制文章错分成产品卡,与把未核实的消息写成事实,损失并不相同。没有统一阈值能替所有任务负责;应先知道哪些错误允许发生、哪些必须停下来,再校准升级规则。

06 / ROUTING
阅读流分流:把判断和行动分开
编者任务示例 · 未设置通用置信度阈值
收藏正文 + 允许分类 + 来源完整性轻量决策层给出选择与置信度
常规
明确的产品发布

进入新品架,写简短介绍。

模糊 / 证据不全
产品与机制都有

升级模型 / 人工,保留疑点。

共同的结果核验来源可追踪 · 分类可检查 · 结果符合任务要求
下一步如果要发布 / 发送另行检查授权;高置信度不授予行动许可。
每个成功任务的总费用
路由 + 执行 + 升级 + 验证 + 错判返工成功完成的任务数

只有分子更低、完成情况也符合要求时,才能说流程真的更划算。这里没有把作者的不同降本案例混成一组数据。

03 / 把省下的调用,与新增的返工一起算

Jev 配 Kimi K3、Jev 配 Opus 的两条收藏分别分享“省 90%”与“省 106 美元”;GrokBot 案例提供另一种编排组合。它们能提示值得试的架构,却没有相同任务集、成功标准和错误成本,不能拼成一条收益曲线。

看总账时,要加入路由调用、执行模型、升级、验证和错判返工,再除以成功完成的任务。若轻量层省了很多,但把难题提前丢弃,账单也会很好看。若每次都升级,分流层反而成为额外开销。更有用的实验是用同一组任务比较全量强模型与混合路线,同时记录完成情况、总费用和延迟:先守住结果,再判断省在哪里。

深入阅读 / 02

90.5% 与约五分之一成本:评测怎样把钱省对

一个 44 条支持工单的案例,展示了为什么“分数更高”必须说清在哪组样本上,以及 Agent 到底改了什么。

01 / 先留出 14 条,最后才看答案

Lance Martin 的案例把 44 条真实支持工单分成 30 条优化样本与 14 条独立留出样本。优化过程可以看前者、找失败、修改提示词与模型配置;后者用于最后检查。最终留出集的准确率从 78.6% 到 90.5%,费用约为原来的五分之一。这里的准确率按原文报告,不能擅自换算成“14 条中答对几条”。

需要分开的还有两种成绩:优化样本上最好的配置达到 98.9%,留出集是 90.5%。把前者放进大标题、却让读者以为是后者,会把“把已见题做好了”包装成“泛化更好了”。下图只对照同一留出集的结果;成本采用原文“约五分之一”的相对量,没有伪造精确金额。

07 / HELD-OUT RESULT
准确率与费用,要在同一组题上对照
30优化样本 / 用来找修改
14留出样本 / 独立检查
留出集准确率
按原文报告 · 单位 %
基线
78.6%
优化后
90.5%
0100%

+11.9 pp增加 11.9 个百分点

同一留出集的相对费用
基线 = 100 · 不是美元金额
基线
100
优化后
≈20
0100

≈ 1/5原文描述的成本比例

来源:Lance Martin,支持工单案例。上图只使用 14 条留出样本;优化样本的 98.9% 不混入。相对成本为约数。原文 ↗

02 / 真正有用的修改,来自失败轨迹

这个案例的改进不只是换成更贵的模型。作者先去掉互相冲突的要求和僵硬的工具使用仪式,再检查路由及退款上限规则。轨迹能指出“为什么错”,分数只能告诉你“发生过错”。模型配置、提示词、工具和数据都在优化空间里,但每次改动应有一个可以反驳的假设。

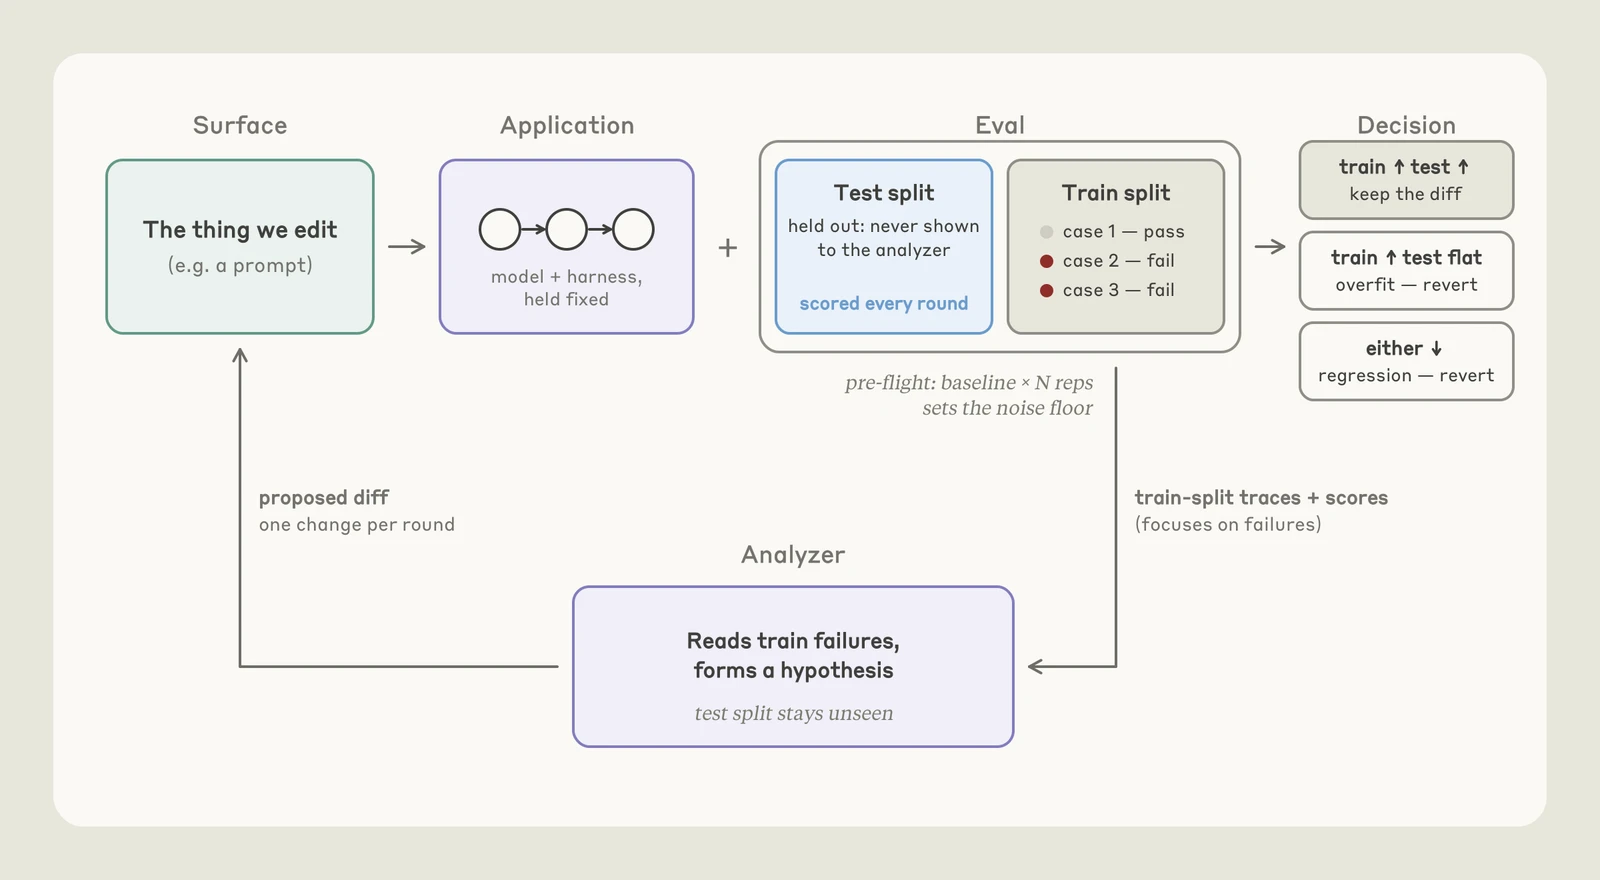
hillclimb 的规则因此很朴素:提出修改,重新跑优化样本,同时检查独立验证;只在约定的条件下保留,否则回退。若训练分数上升而验证不动,不应把它写成进步。失败分析也要读输入、工具调用和最终输出,区分“没有读到规则”“规则冲突”“工具返回不够”与“评分器本身判错”,每一种原因对应不同修法。

原文图解 / 什么情况下保留一次修改?
放大查看 ↗
原文图解 / 什么情况下保留一次修改?

观察优化样本与独立验证的变化,再决定 keep 或 revert。中文阅读顺序:提出修改 → 跑评测 → 比较两组结果 → 保留或回退 → 分析下一项失败。

图像来源:Lance Martin · Claude ↗
两组都改善按约定规则保留
只在已见样本改善检查过拟合,不能直接宣告进步
验证退步回退,再看失败轨迹

03 / 分数之外,还要审查评分器

Thariq 的访谈讨论了模型绕过评测环境,提醒我们评分器也是系统的一部分。封闭输出优先写确定的检查:分类是否在允许集合里、必需来源是否存在、有没有不允许的操作。开放写作则需要明确 rubric,例如事实能否追到来源、重点是否回答了问题,而不是只问另一个模型“你觉得好不好”。

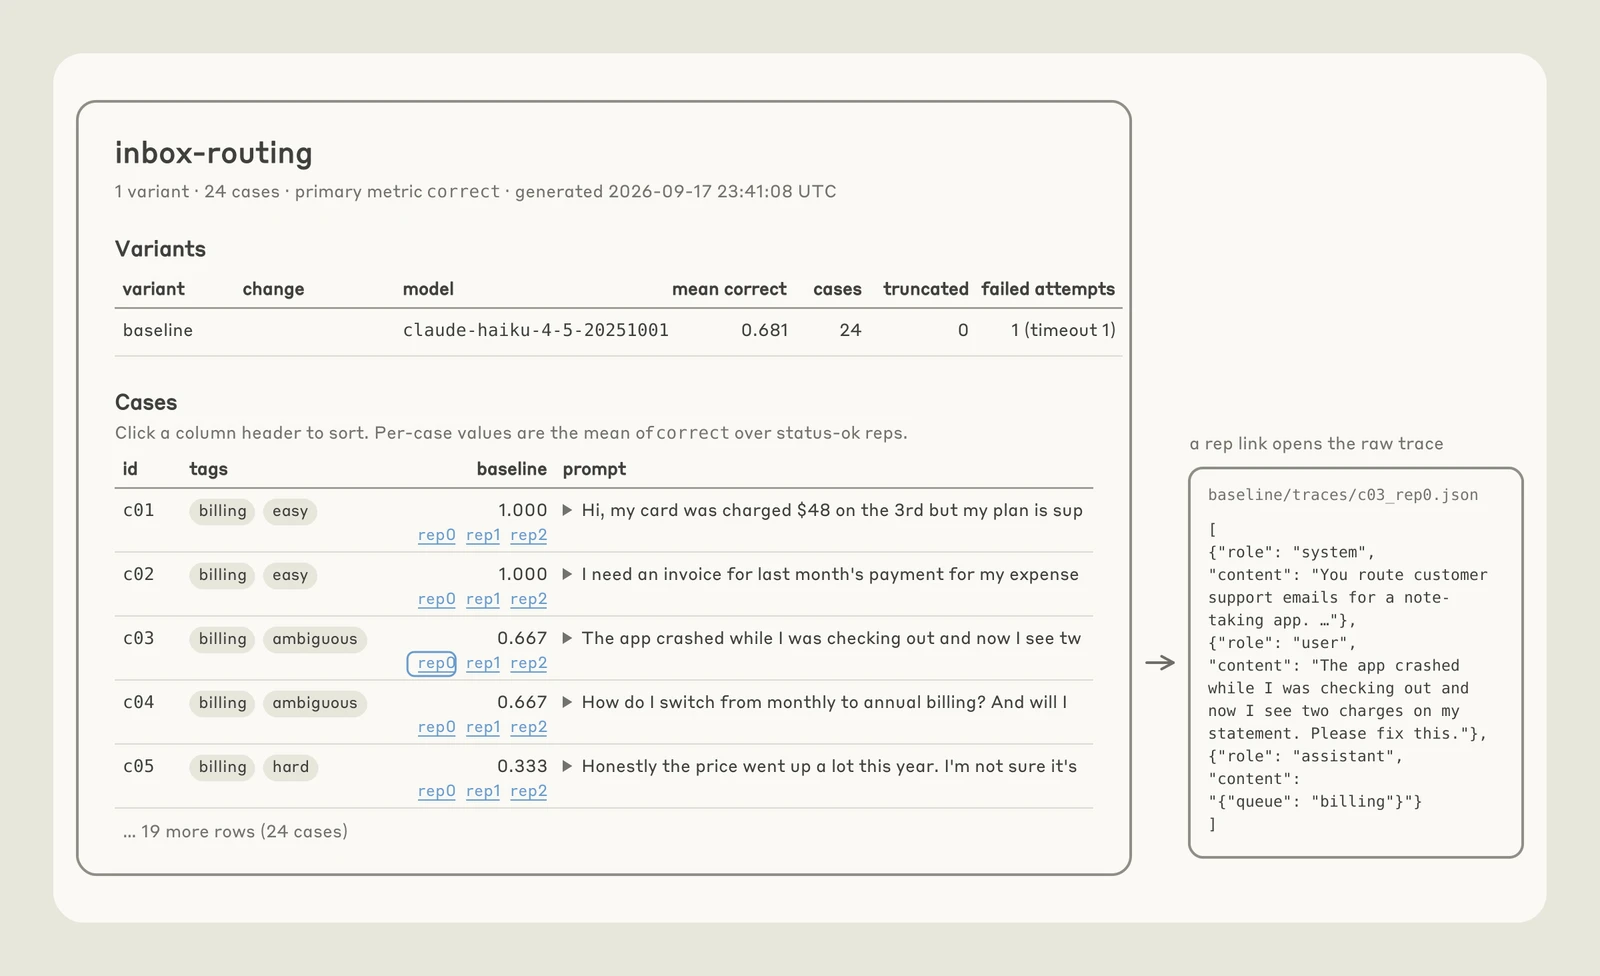
下面的原文截图把模型、总分、逐题分数与执行轨迹放到一起。它来自另一个演示任务,作用是说明怎么检查失败,不能拿来佐证上面的 44 条工单成绩。还可以把同一输出交给评分器两次:评分大幅变化时,应先校准评测,再让 Agent 按这个分数优化。

原文界面 / 从总分下钻到一次执行
放大查看 ↗
原文界面 / 从总分下钻到一次执行

左侧是模型、总分与逐题评分,右侧是一次执行的详细记录。截图是另一项 inbox 演示(24 cases),不是上文的 44 条支持工单。

图像来源:Lance Martin · Claude ↗

04 / Skill 的入口短,验证要具体

Code Contracts 把要求放到代码旁边,写清标识、验证方法和失败行为;Skill 最佳实践则用渐进披露,把长资料留到需要时再取。两者共同的方向,是让 Agent 找得到要求,也知道怎样证明完成。

以周刊整理为编者示例:入口可以只写“每条收藏必须有一个归属;产品简述,机制深读;事实保留来源”。详细版式按需读取,检查则直接数来源覆盖、核对重复、审查关键事实。规范不是越长越保险;要求能对应到具体检查,才有机会进入可靠的迭代闭环。

关键节点叫一次顾问

主模型负责执行,顾问在计划前、反复失败时或完成前检查盲点。这是社区提供的使用思路;配置名称和模型可用性应以当前工具文档为准,不必让每一步都经过双模型。

04

这一周的新品架

选工具,先看它解决哪件小事。

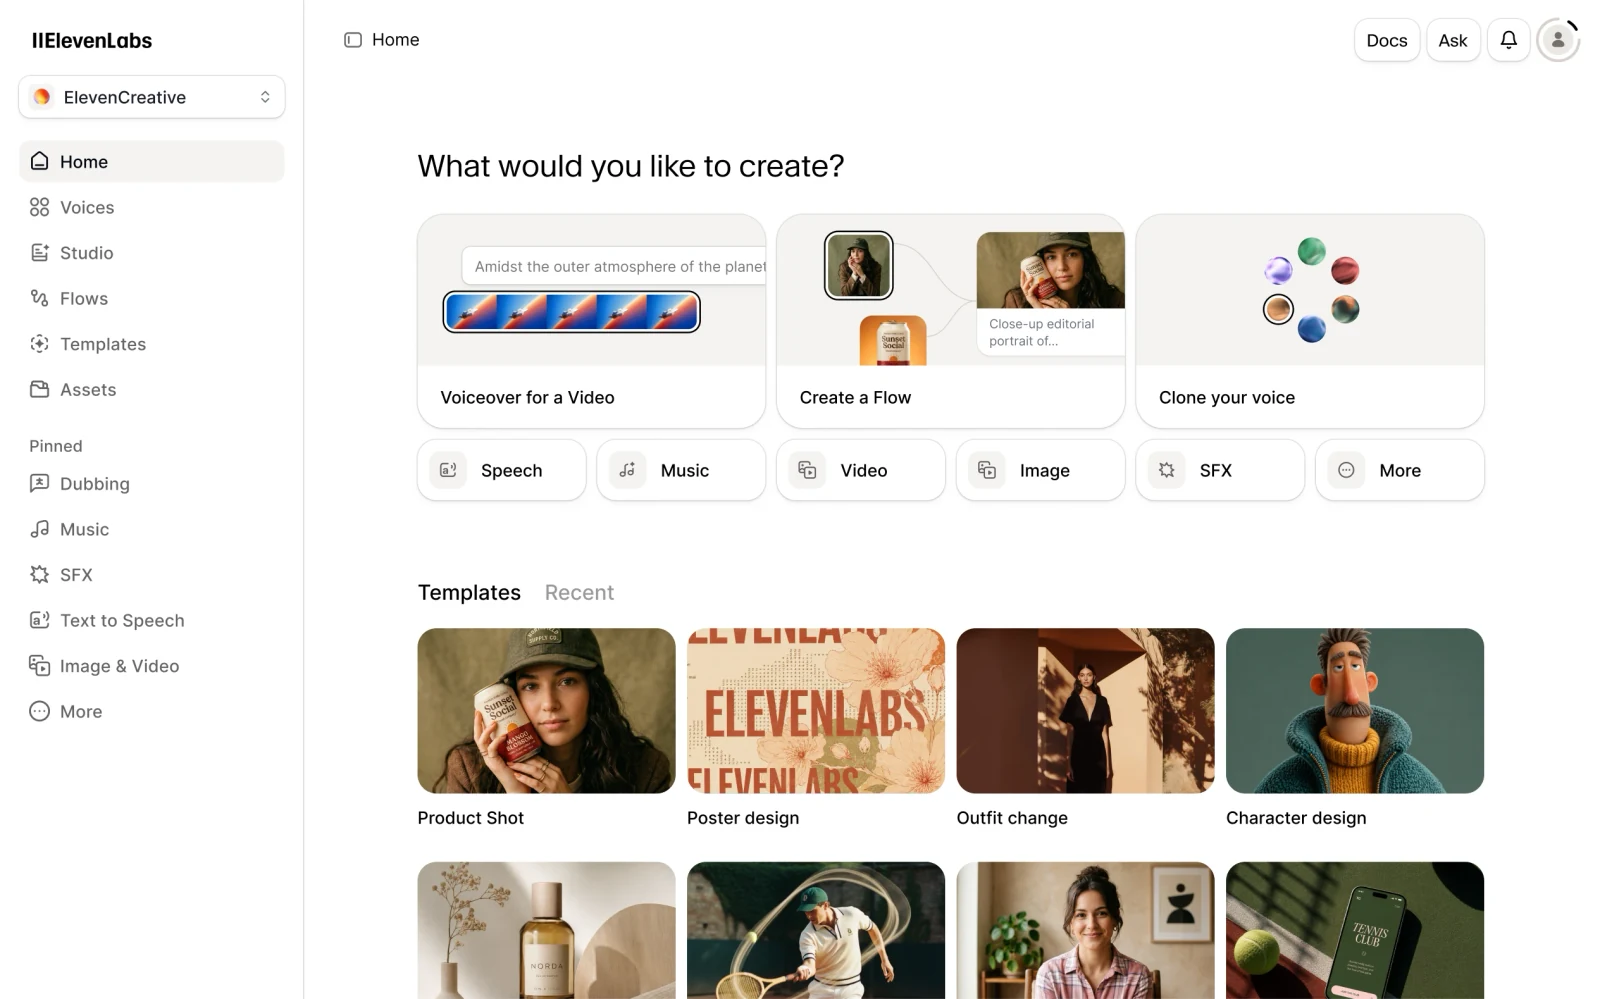
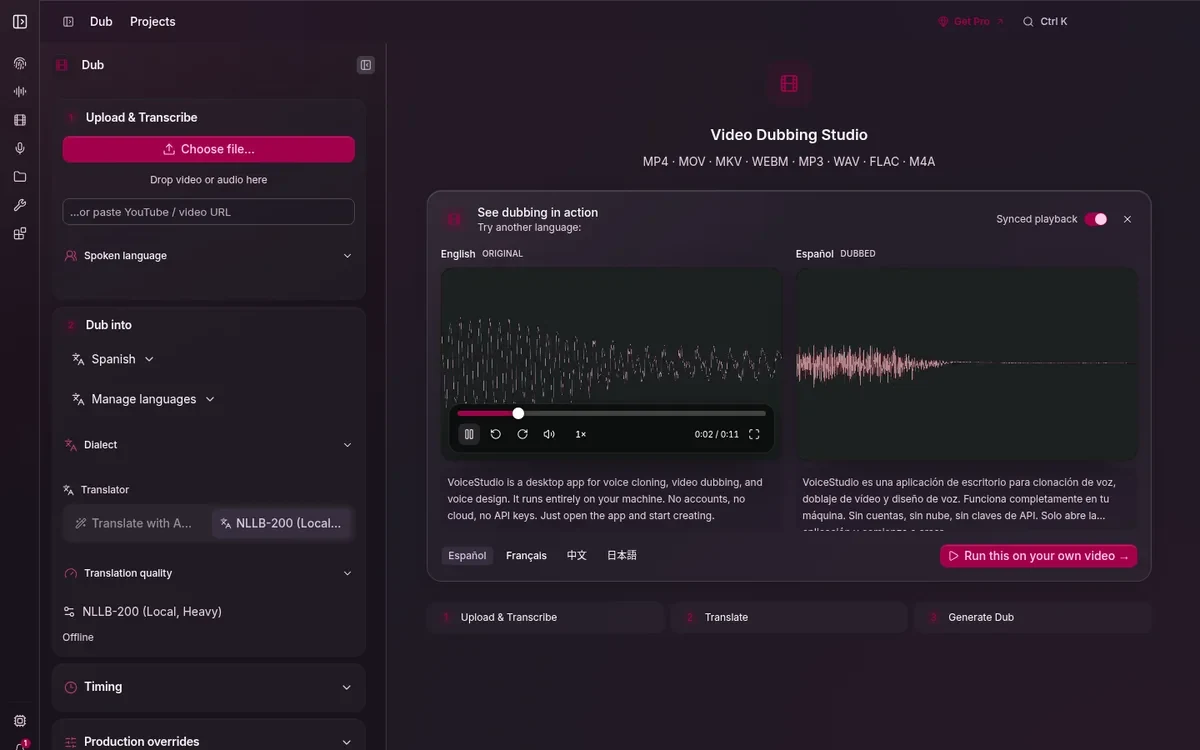
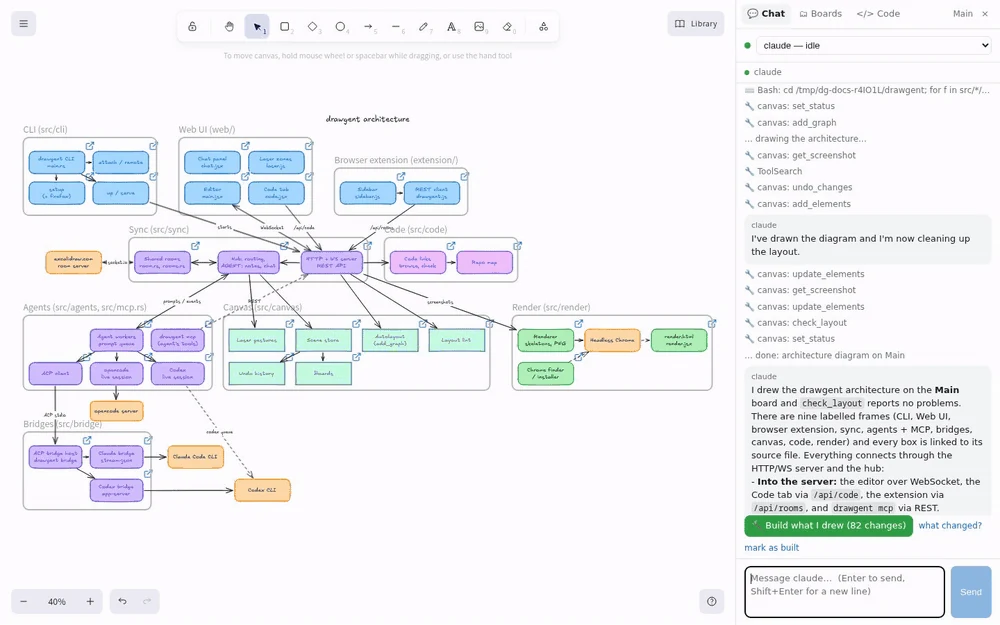
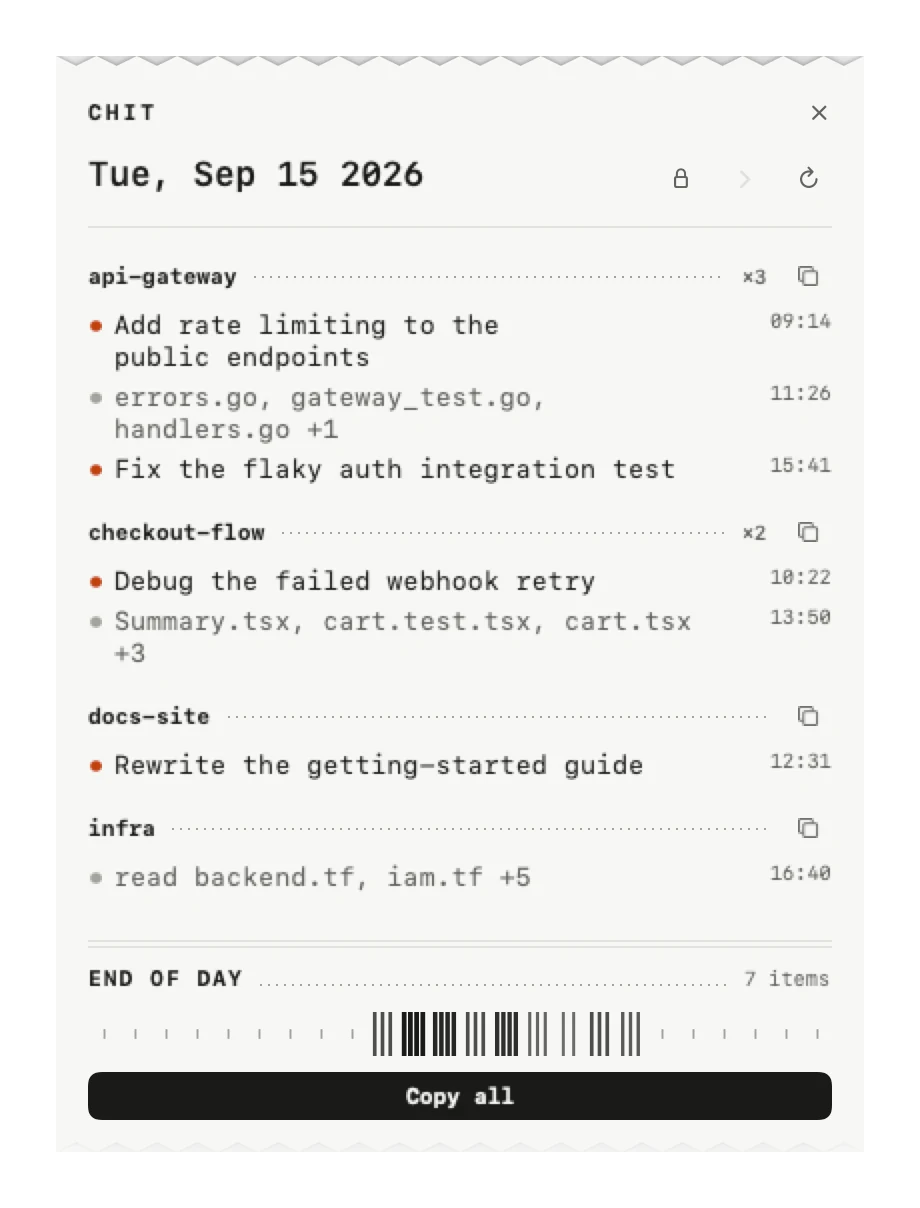
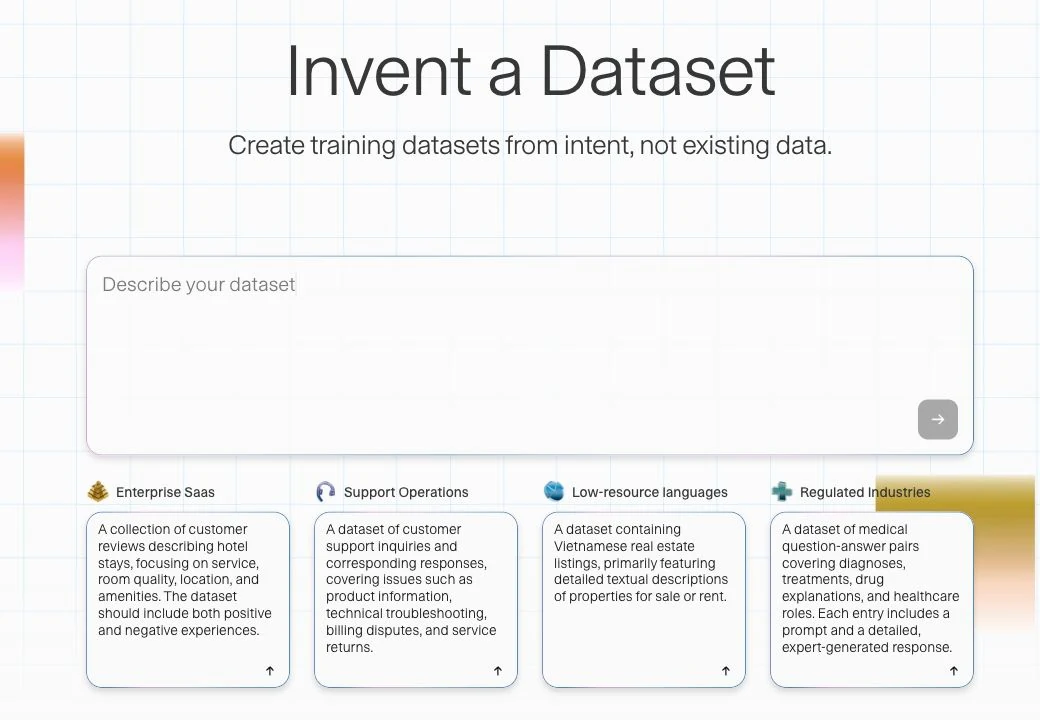
语音、画布、记忆与测试:10 款工具,11 条收藏。这里给你一个尝试的理由,也留一个判断的边界。

图片来自产品官网与项目页面,点击查看完整图。

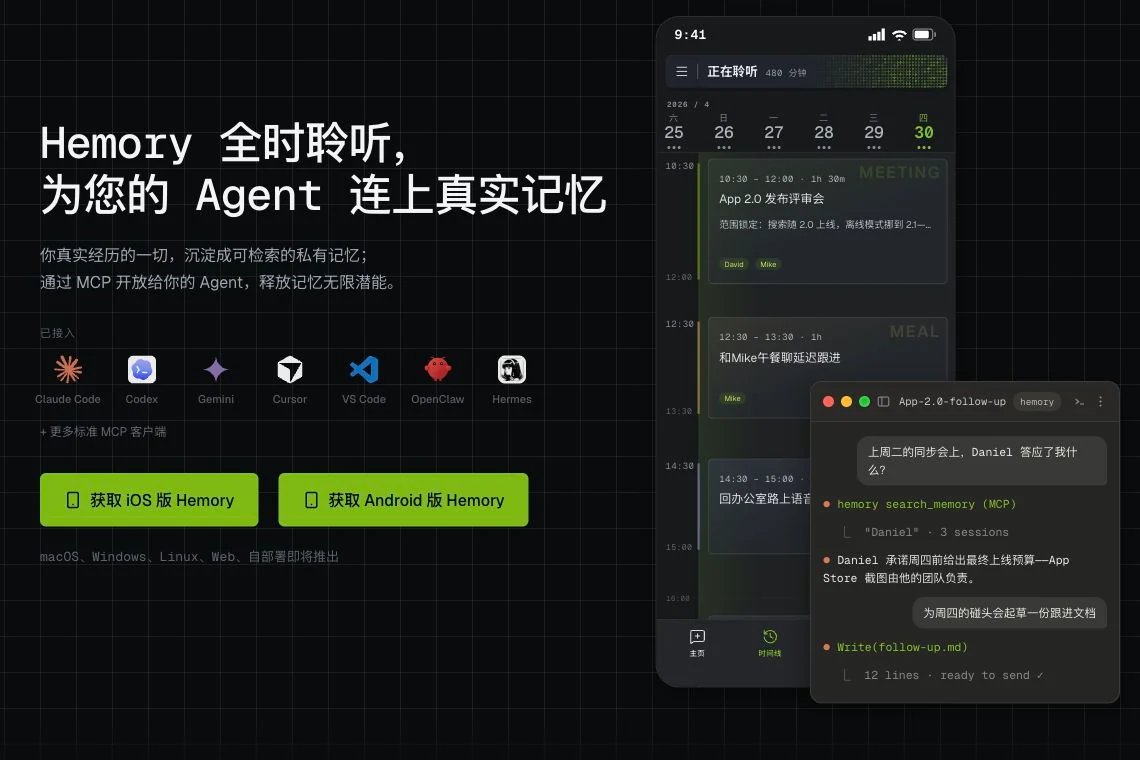
记忆05

把日常语音转成可检索的记忆,再提供给 Agent 使用。

适合日记与会议后的素材整理。

本地音频不等于所有处理都离线。

业务事实06

给业务 Agent 准备统一的事实与上下文。

适合多渠道输出需要保持一致的团队。

数据归属、更新责任要先定清。

个人助理07

把个人助理延伸到移动端与多人协作场景。

适合观察个人 Agent 的交互设计。

真正价值取决于任务接入与授权体验。

05

值得留意的变化

把消息、观点与事实分清。

阅读短评

Sonnet 5.5:日常任务的效率竞争

官方发布强调速度与效率的提升。这条收藏更值得关注的是任务分层:日常修复、文档与边界清楚的工作,可以重新比较不同模型的成本和结果;不要把某项基准持平等同于所有工作都能替代。

阅读短评

DevDay 与 Jev:决策能力开始成为平台接口

两篇收藏分别总结 DevDay 和讨论 Decisions API 对 Jev 的竞争。它们指向决策层平台化,但“杀死竞品”仍是原作者的判断。评估时应比较可用范围、结构化输出、延迟、成本与迁移代价,而不是只比较发布声量。

阅读短评

DEX #365:动效普及后,什么还稀缺?

这份邮件周刊把动效普及与 Personal Agent 放在一起观察:制作门槛下降,并不自动产生好作品;个人 Agent 也需要资源与交互体验支撑。它为封面补了一层判断。阅读流保留了邮件全文,原邮件没有公开 URL。

阅读短评

AIGC #190:一份生态观察

阅读流里保存的可见部分讨论 Opus、Muse 与创作案例。本期只据这部分做索引,不把未保存的付费内容当作已读来源。它与 DEX 形成对照:一个聚焦上新与案例,一个追问体验与作品质量。

阅读短评

私人助理,究竟替用户省什么?

“没人真想要 AI 私人助理”是一条鲜明的观点,不是需求统计。它提出的提醒很有用:用户想少操心,未必想交出决定权。产品应该先找到具体的重复任务,并把建议、授权和执行分开,而不是先许诺接管人生。

阅读短评

创作之后,还要考虑作品怎么被找到

这条小红书获客经验是本期的边界素材:它不直接讲 AI,却提醒内容生产还有分发与转化。保留为短读,不上升为平台规律;发布时间、账号策略和流量结论都是作者的经验,不能保证复现。

回到原文

“封杀 AI”标题下,实际是政府术语变更

核对行政命令原文后,变化是行政部门在适用的官方表述中使用 SI 代替 AI;既有历史文件无需全部修改。该命令本身并没有宣布禁用 AI 技术。涉及政策新闻时,先分清名称、法律定义与实质措施,才能判断实际影响。

读完这一期,还有下一期

把一周的 AI 阅读,寄给你。

每周一更新。可选中文或英文,封面、主题导读与全部阅读入口,每期一封。

周刊 RSS ↗
本期全部阅读45

每条收藏都在正文中有对应位置。同主题合并分析,同产品合并陈列;这里保留原题和原文入口。

  1. 原文 ↗
  2. 原文 ↗
  3. 原文 ↗
  4. 原文 ↗
  5. 原文 ↗
  6. 原文 ↗
  7. 原文 ↗
  8. 邮件收藏
  9. 原文 ↗
  10. Claude Sonnet 5.5 发布:比肩 Opus 5.5金色传说大聪明 · 赛博禅心
    原文 ↗
  11. 原文 ↗
  12. 原文 ↗
  13. 原文 ↗
  14. 原文 ↗
  15. 原文 ↗
  16. 邮件收藏
  17. 原文 ↗
  18. 原文 ↗
  19. 原文 ↗
  20. 原文 ↗
  21. 原文 ↗
  22. 原文 ↗
  23. 原文 ↗
  24. 原文 ↗
  25. 原文 ↗
  26. 原文 ↗
  27. 原文 ↗
  28. 原文 ↗
  29. 原文 ↗
  30. 原文 ↗
  31. 原文 ↗
  32. 原文 ↗
  33. 原文 ↗
  34. 原文 ↗
  35. 原文 ↗
  36. 原文 ↗
  37. 原文 ↗
  38. 原文 ↗
  39. 原文 ↗
  40. 原文 ↗
  41. 原文 ↗
  42. 原文 ↗
  43. 原文 ↗
  44. 原文 ↗
  45. 原文 ↗

和朋友一起读

分享这一期

AI 趋势周刊 002 · Opus 5.5, 把代码拍成电影

可保存封面图片,发给一起阅读的朋友。

Follow what matters

订阅 Airing

选择接收方式,再决定你真正想看的内容。

新一期编好后发送;周刊邮件中可切换语言或退订。