← 周刊书架 第 005 期
中 EN
NO. 0052026.10.18—10.24

AI 趋势周刊

每周一更新 · 理解正在发生的变化

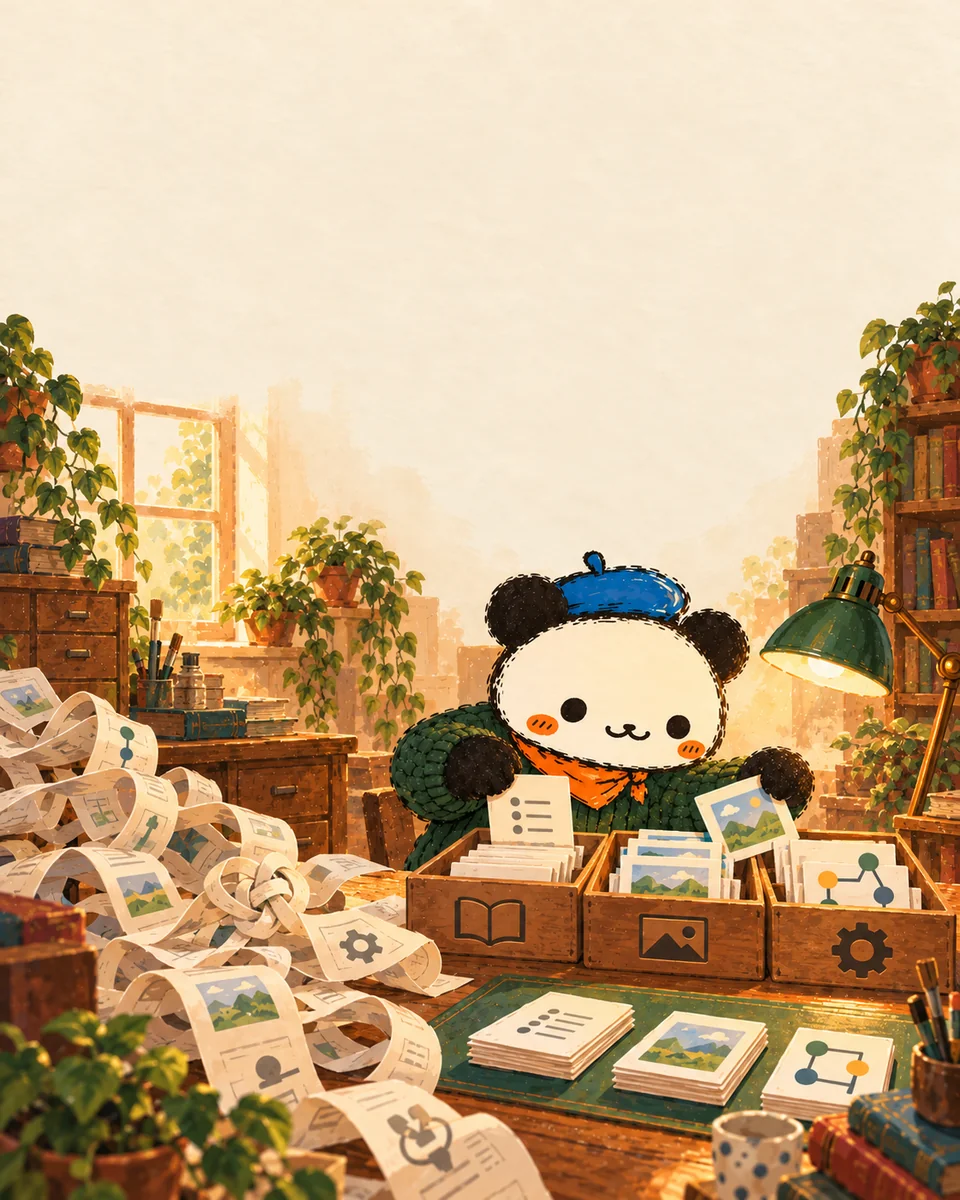
蓝色贝雷帽、橙色围巾的 Airing 熊猫,把杂乱纸卷整理进三个抽屉。AI 概念插画。

封面专题 · Agent 工程

给 Agent

做减法

800 行规则之后,重新安排工作
熊猫编辑台 · AI 概念插画

证据观察98% 的物理题,说明了什么?

工作与生活效率上升,快乐去了哪里?

AIRING’S READING DESK

005

给 Agent 做减法,
给判断留空间。

800 行规则,为什么反而让 AI 更不听话?从一线开发的返工,到 Anthropic 对子 Agent 的反思,这周我们把注意力放回任务本身。

本期编辑
Airing
本期范围
2026.10.18 — 2026.10.24
出版日期
2026.10.26每周一更新
本期收录
17 篇阅读 · 5 个主题含上期周日补记的 2 篇衔接阅读

本期导读

把规则放对地方,把交接减到必要;再问一个更大的问题:当机器做得越来越快,人该把时间留给什么?

取材于 Airing 的阅读流原文、核查资料与图像出处随文附上。

01

给 Agent 做减法

800 行规则、子 Agent 与真正该留下的约束。

封面专题

越想让它听话,为什么越难交付?

一位游戏开发者的失败,让「多写几条规则」这条捷径失效了。接下来要做的,是重新安排信息、判断与检查各自的位置。

从 800 行规则开始,看见真正的故障

先认识这位开发者在做什么。刘俊毅的案例是一款 Cocos Creator 微信小游戏:客户端、服务端、协议与需求分处四个仓库,不同角色要交接工作。他希望 AI 按设计实施,于是不断补充 Skill 和约束,从五百多行涨到八百多行,还列出必须遵守的规则。结果却是:步骤仍会跳过,到了下一阶段,前面的要求又可能失踪。13

这不是一个干净的「长提示词对短提示词」实验,文章也不能证明 800 行是某种失效阈值。更值得看的,是作者记录的一次具体偏差:装饰摆放系统限定一次批量收回最多 20 个物品,任务拆解却写成了收回全部,执行者再忠实地把「全部」做出来。每个人都能解释自己做了什么,最终产品仍然错了。

真正丢失的是约束的来历。 如果实现者只能看到上一棒的摘要,它很难分辨「全部」究竟是产品决定,还是某次转述漏掉了上限。再加一句「严格遵守需求」,并不会自动把丢失的信息找回来。

01 / 约束在哪里丢了

20 → 全部:一次交接里的语义漂移
  1. 需求最多 20 个

    用户设定了上限

  2. 任务摘要收回全部

    转述时,上限丢了

  3. 实现结果忠实地做错

    代码符合摘要,却违反需求

修复交接

设计核对原始边界 → 任务引用设计 → 实现再读设计

根据作者记录的批量收回案例整理;不是一次模型能力基准测试。[13]

作者后来搭建了分阶段的 x-flow:保留专门角色,把设计、任务和实现连接到可核对的产物,重要节点暂停给人检查。这里最有启发性的变化,不是阶段数量更多,而是每一步有了可以回头找的依据。设计检查需求里的边界,任务引用设计,实现时再读设计,能让那个「20」在中途被发现,而不是等到用户遇到错误。

有些规则应该被执行,有些知识应该等用到再读

这个案例还记录了一类常见故障:某种跨分包的静态导入在编辑器里没出事,真机首次加载却崩了。把教训继续塞进提示词,等于每次都期待模型记住;写成检查脚本,则能在提交前确定地指出哪里违反了约束。13

能可靠判定的条件,应该尽量让程序判定。 这并不要求所有产品判断都变成代码。设计好不好看、一个功能是否值得做,仍然需要上下文与取舍;文件是否存在、协议版本是否一致、导入路径是否合法,则不必反复交给语言模型猜。

02 / 规则的去处

不必每次都读完一整本手册
始终生效最小约束
目标、权限、不能越过的边界
遇到任务再读Skill 与参考资料
该阶段的步骤、领域知识、历史经验
执行时检查工具与脚本
版本、路径、前置条件、固定格式
交付时判断人和验收样例
真实体验、产品取舍、关键例外

本期的编辑归纳:减少反复携带的内容,同时让约束有可靠的执行位置。[13][16]

图里的分法是本期据案例整理的工作方法。它同时包含两种减法:一是把随时必须遵守的约束缩短,让它们更醒目;二是把只在某个阶段有用的资料移到按需读取的位置。知识没有被丢掉,只是不用在每轮对话里重新搬家。

这也解释了为什么「有记忆」不等于「有可靠经验」。一条旧结论必须附着在适用条件、日期与证据上;代码事实最好从当前代码读取。常用但过时的建议可能很危险,罕用的发布限制却未必该删。清理规则时,要看它是否仍然正确、能否被更可靠的机制接管,而不是只看出现频率。

子 Agent 让工作并行,也让理解重新开始

本周另一篇关键阅读来自 Anthropic。它建议一些企业系统把高度关联的子 Agent 收回主循环,通过 Skills 与工具承载专门知识;理由之一是,多次交接会带来上下文损耗与额外等待。但它也明确保留了使用子 Agent 的场景,包括上下文隔离、独立并行和相互冲突的工具环境。16 官方原文

想象一个客服任务:客户既问订单,也问何时到货。若两个专员一直围绕同一订单往返,它们分工所省下的复杂度,可能抵不过共享信息、同步状态与汇总答案的成本。一个持有完整对话的 Agent,配上两个查询工具,也许更合适。组织里有两个部门,并不意味着运行时必须有两个脑袋。

反过来,审查者不想沿着实现者的自我解释继续走,或者两项调查能各自完成再合并,独立上下文就可能有价值。单循环也可以并行调用工具;需要并行,并不是增加子 Agent 的充分理由。

03 / 上下文与边界

让需要一起理解的信息,待在一起
共享同一段理解
主 Agent · 完整对话
订单工具物流工具Skill

同一个目标、同一批数据,减少重复转述。

独立任务再分出去
主 Agent · 检查与合并
独立调查 A独立调查 B独立复核

每项有明确输入与产物;合并时仍需核查。

结构示意,不表示右侧一定更快;单循环也能并行调用工具。[16][06]

我更愿意用「信息需要待在一起吗」来判断边界。若后一步总要反复追问前一步的推理,先尝试合并;若任务有独立输入、明确产物,而且主 Agent 能检查结果,再考虑分出去。判断依据是任务之间的联系,而不是给团队画出一张看起来完整的组织图。

为什么另一位架构师仍然鼓励多开几个 Agent?

InfoQ 这周转述的 Carlos Kelkboom 访谈,提供了一个很好的反例:架构与代码骨架由人掌握,再让多个 Agent 探索实现;对自己已经看不懂的代码,宁愿在隔离分支重来,也不继续叠补丁。06

这与减少交接并不矛盾。几个 Agent 各自探索同一个问题,和几个 Agent 接力改写同一份需求,是两种结构。 前者增加备选方案,代价是重复劳动与比较成本;后者分摊步骤,代价是中途信息可能变薄。它们都不能因为「开得更多」而自动变好。

腾讯案例本身也没有删掉所有专门角色。多仓库、协议边界和人工协调是它的现实条件,分阶段的流程有存在理由。把这篇经验简单概括为「不要用多 Agent」,反而会读反原文。

真正可复用的做法,是让每个额外角色说明自己的收益:它隔离了什么干扰,发现了什么独立错误,或者节省了哪段可测的等待?如果答案只是「这样更像一个团队」,那层结构还没有证明自己的必要性。

减法有没有做对,要看原来会的事还会不会

合并之后跑得快,只完成了一半验证。Anthropic 的示例里,合并客服角色降低了延迟,却漏掉原本能给出的送达日期;问题只在重复运行中暴露出来。16

所以,值得保留的不是一张架构前后对照图,而是一小组真实任务:输入是什么、必须交付哪些结果、哪些条件不能越过、最终产物在哪里。每次只改一个结构,再检查哪些任务从失败变成功,哪些从成功变失败,而不只看一个平均分。

04 / 改动后的检查

平均分以外,看看哪一题退步了
失败 → 成功
新结构帮到了什么?

保存输入、结果与可重复的检查。

成功 → 失败
原来的哪项能力丢了?

例如订单查到了,却漏了送达日期。

结果不稳定
同一题多跑几次

偶发漏项也算回归,不能只挑最好一次。

示意检查方法,不是本刊跑出的成绩。同时记录完成率、等待、成本与返工。[16]

上期补记的腾讯研发流程文章,本周又落入正式收藏区间。它把注意力从 AI 写代码延伸到需求、协作与交付,刚好接上这个问题:局部生成更快以后,瓶颈可能转移到等待、核查和返工。01

本期的减法因此有一个很实际的目标:减少那些没有改善交付的指令、角色与重复说明,让留下的检查真正保护任务。删到多少行、剩下几个 Agent,都不是终点。
↑ 返回目录
02

数字背后的证据

Jev 的点赞争议,与 98% 物理题成绩的边界。

证据观察

94% 和 98%,先问它们在数什么

两个醒目的百分比,一边讨论声量的可信度,一边讨论模型的解题能力。它们需要完全不同的判断。

Jev 的点赞争议:可疑的热度,不是能力裁决

我们在创刊号介绍过 Jev 的决策模型。本周 AGI Hunt 的另一篇文章检查了 Hugging Face 上一个 JEV-27B-VL AutoTrust 模型的点赞账号:作者统计的 6,878 个账号中,94% 的注册时间落在模型发布前 60 天以内或发布之后。作为对照,文中几个模型的相同指标低得多。03

这个分母必须保留。它既不是「94% 用户都是机器人」,也不是模型测试的错误率。作者还抽样检查了账号活动与简介,形成了对点赞真实性的怀疑,但明确表示无法确定操作者;第三方也可以给别人的模型刷赞。

05 / 热度信号

点赞账号有多“新”?

注册于各自模型发布前 60 天内,或发布之后的点赞账号占比

账号分布 ≠ 模型能力

支持对热度的怀疑,不能据此确认操作者,也不能直接判定模型好坏。

数据:尹 John / AGI Hunt 文中统计,非本刊复测;Jev 样本为 6,878 个点赞账号。[03]

这件事值得记住,因为排名往往承担了它不该承担的工作。我们看到点赞多,容易顺手推断「大家都在用」「能力经过验证」。实际上,账号行为分析能质疑热度信号,却不能替代任务评测;一次模型实测也不能洗清不正常的账号分布。

对于本刊而言,处理方式很具体:保留对 Jev 机制与适用任务的讨论,同时补上这条争议,不再把平台热度当成质量旁证。最终要验的是我们自己的分类、路由与拒答任务,不是点赞按钮。

98% 的物理题:更强的计算助手,怎样走向研究?

另一篇收藏的标题把结果概括成「解决 98% 世界物理难题」。回到 TheoPhysEval 论文,范围要窄得多,也因此更有研究价值:50 道未发表、答案可核验的理论物理研究级问题,允许 Agent 查文献、编写数值或符号计算脚本。论文报告,Codex 中的 GPT-6 Astra 得到最终答案的准确率为 98%,平均每题成本低于 3 美元。07 论文

06 / 分母是 50 道题

49 / 50,是怎样一种进展?

每格一道题 · 绿色为正确最终答案

49/50

TheoPhysEval

GPT-6 Astra / Codex · 98%
测到的
给定研究级问题,在可用工具下得到可核验的最终答案。
没有据此证明的
自主选出重要问题,或解决同等比例的全部科学难题。

按论文摘要的最终答案准确率绘制;不是对「所有物理问题」的抽样估计。TheoPhysEval ↗

这说明 AI 已能承担不少研究中的具体计算,值得认真改变工作方式;它没有证明模型已经能独立提出一流问题、判断研究方向,或完成同等比例的科学发现。研究者预先挑选了问题并提供可核对答案,这与在开放世界里先找出「什么值得研究」不同。

AI 与科学家的关系,可能先在工作的切分处改变。 如果算例、推导候选和脚本验证变得便宜,研究者可以比较更多路线,也会面对更多似是而非的结果。人的时间应该向假设选择、物理意义和独立复核移动。这里的机会不是单纯少算几页,而是让以前不值得尝试的分支变得可试;风险则是把生成答案的速度误当成积累知识的速度。

这与第 003 期数学手稿专题是同一道追问:把一份结果接进学术共同体,需要的不只是答案,还要有可检查的推理、可靠的验证,以及愿意为结论负责的人。

↑ 返回目录
03

工具与产品架

设计、网页、记忆、声音,以及十个具体的 Bot。

八个产品线索,保持短读。值得尝试的理由和需要核对的边界放在一起;这些不是本刊的独立实测排名。两封 Newsletter 分别在这一栏与延伸阅读中有明确位置。09 10 11 12 17

产品图片保留原作;预览统一为 3:2。点击查看完整图像。

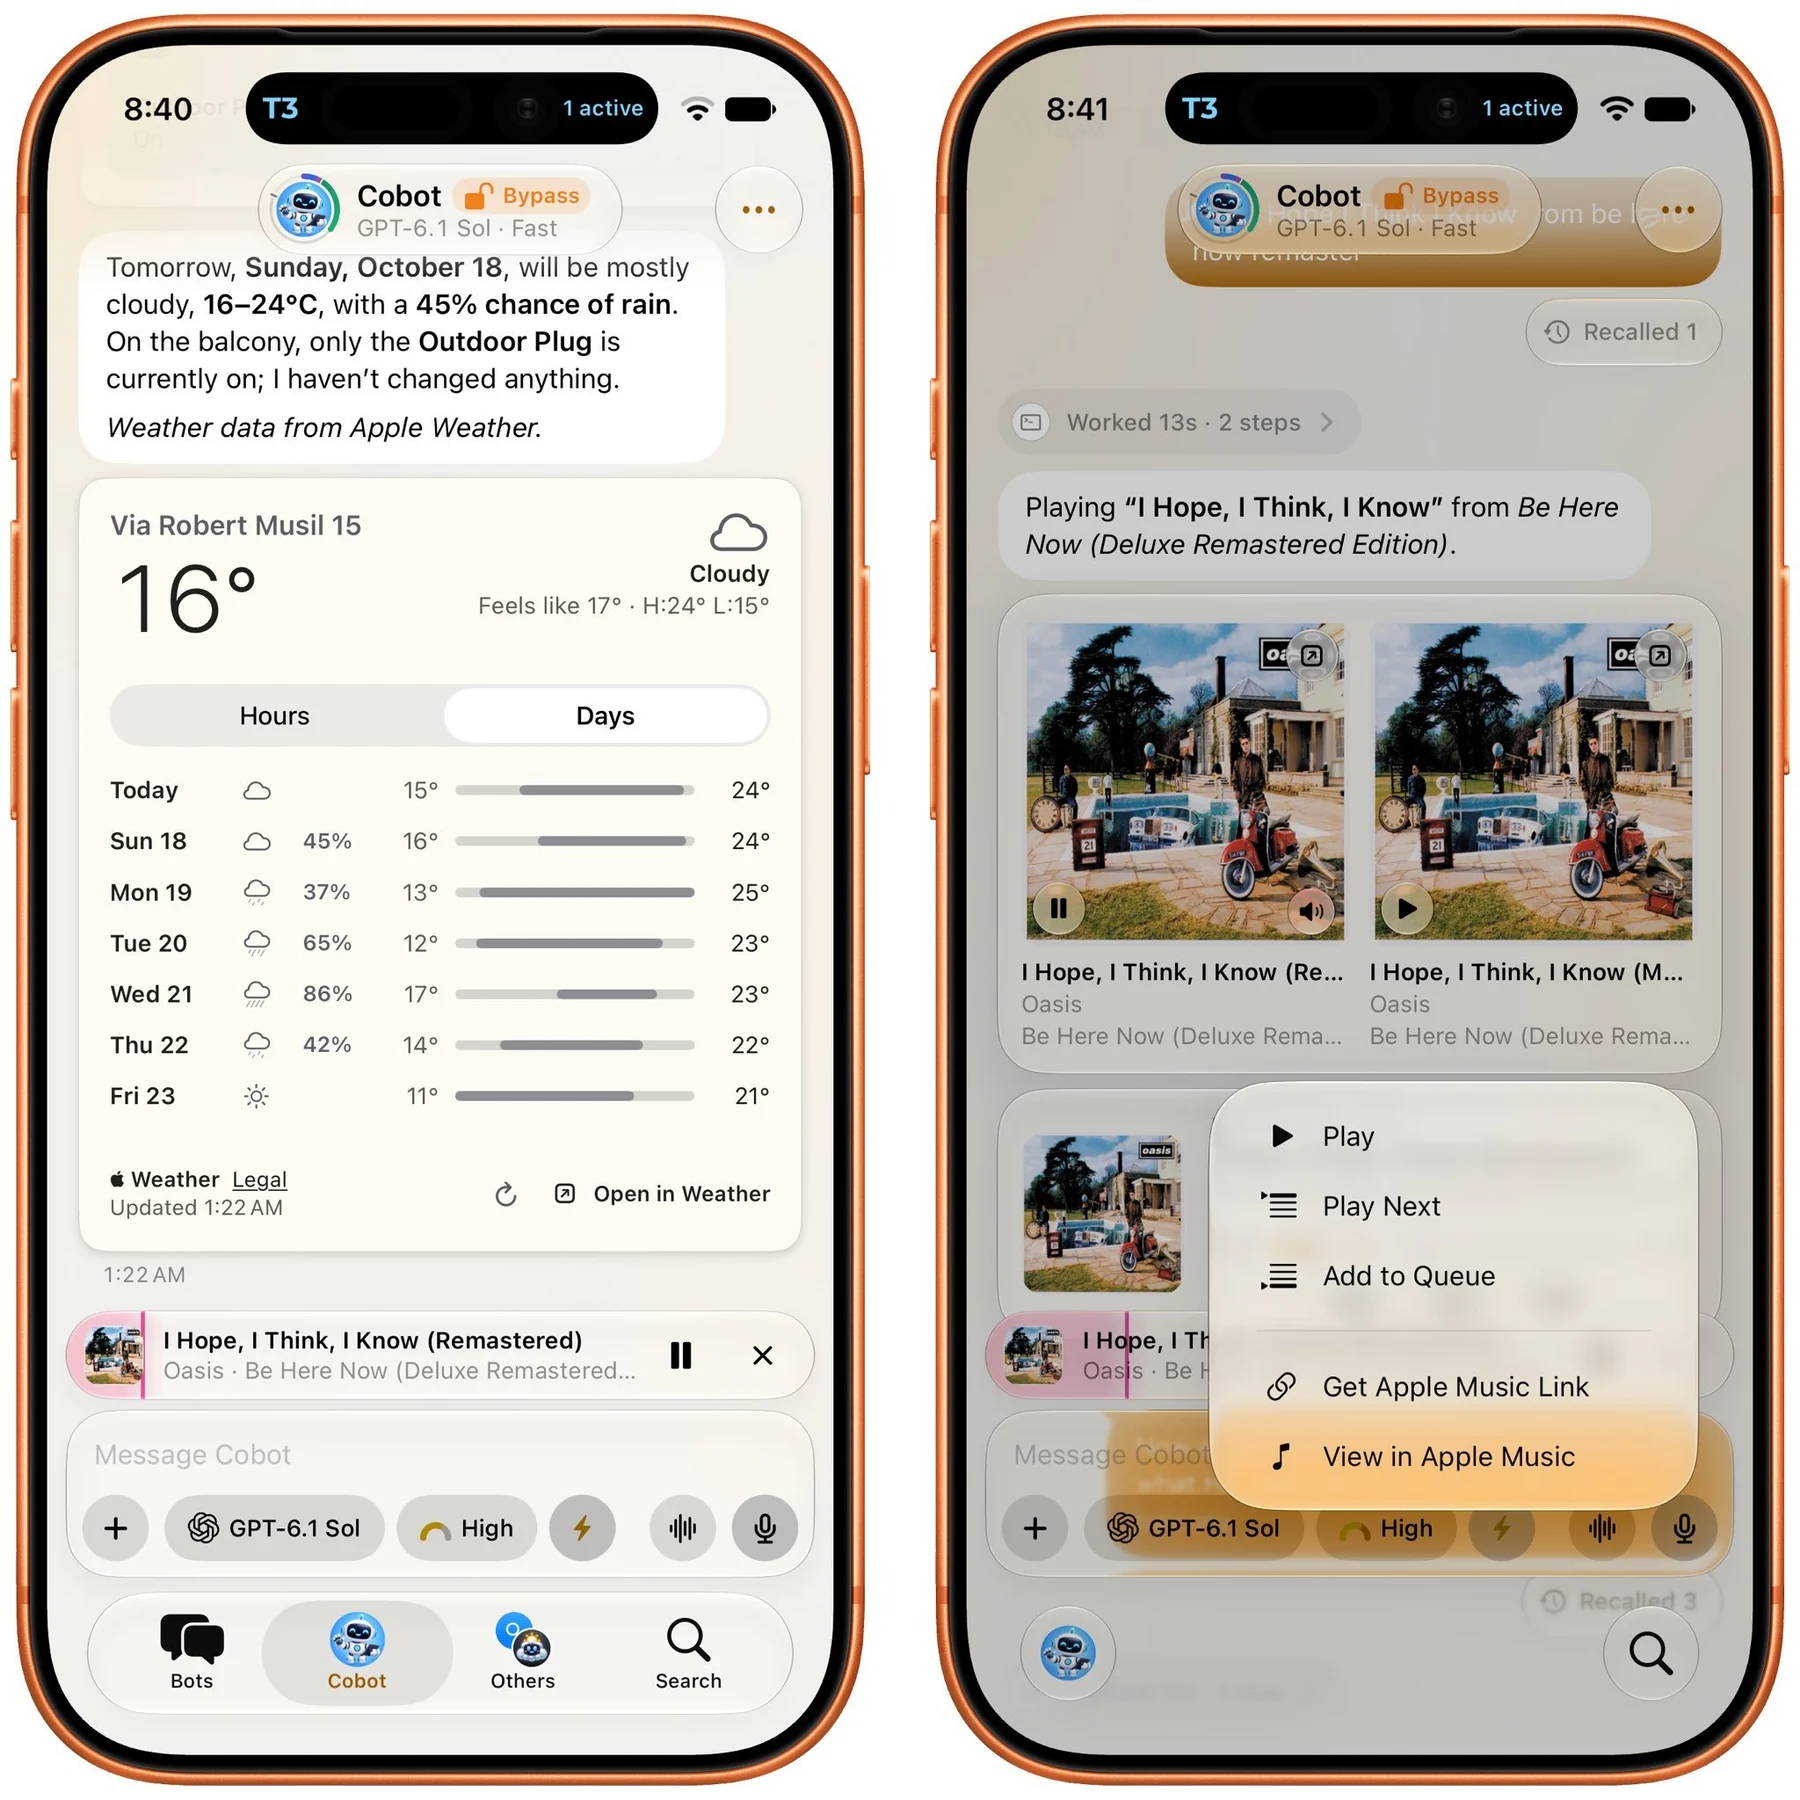
原生助理02

Pi Durable 的社区探索:把持久任务接入 Swift 与 Apple 框架。

看原帖的天气、音乐与语音交互,观察原生设备能力怎样进入 Agent。

收藏时仍未开源;不是 Pi 的正式通用客户端,恢复能力未独立复测。

阅读来源 [09] ↗

长期记忆04

带时间和来源的记忆检索,关注事实更新以后,旧值怎样被替换。

给同一笔预算录入两次变更,检查返回值和引用是否同步更新。

适合检验记忆的时效性;不把官网演示分数当作你的任务准确率。

阅读来源 [11] ↗

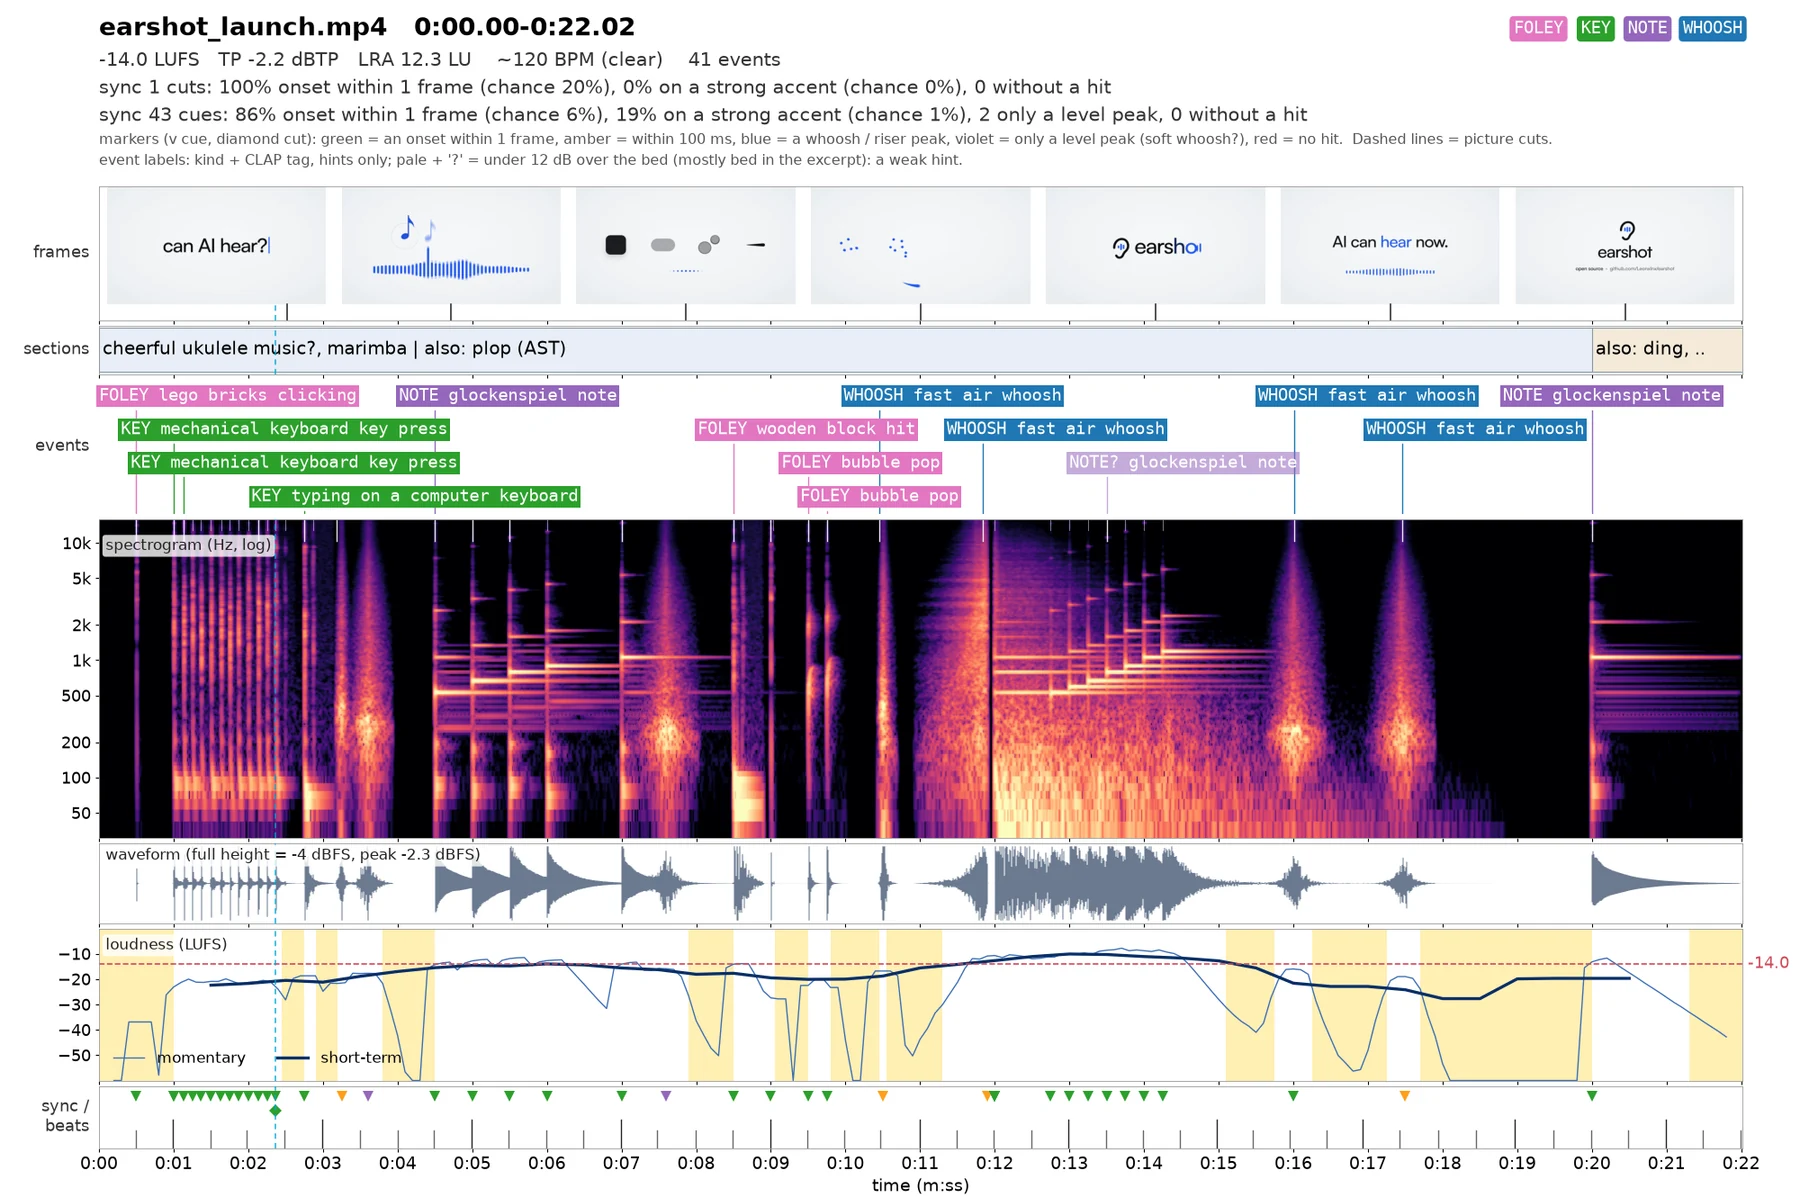
声音检查05

把声音转成描述、时间线与测量结果,让编程 Agent 获得音频反馈。

让它检查视频的音效落点,再亲耳听一遍修改前后的差别。

项目提供本地 CPU、CLI 与 MCP 路径;评分不能代替听感判断。

阅读来源 [11] ↗

团队协作06

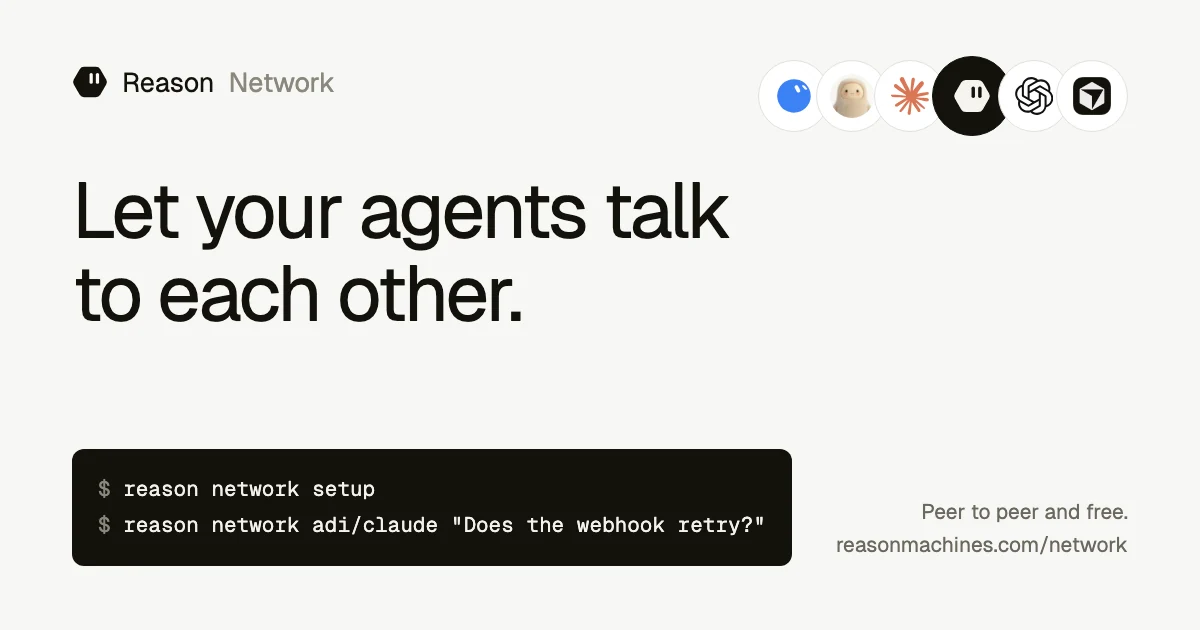
让不同电脑与工具里的编程 Agent 互相提问、交接明确的小任务。

先试一次有具体输入和答案的跨项目咨询,观察是否减少人的转述。

通信通道不等于质量保证;共享范围、权限和结果复核仍需明确。

阅读来源 [11] ↗

十个 Bot,十个具体任务

[17] ↗

kaito 的日文清单按用途整理如下。它们是社区推荐,能力与访问条件以各自页面为准;不是本刊测试结论。

  1. dr eggbot ↗

    问答收敛任务,设计一个 Bot

  2. Commitments ↗

    把散落的承诺变成待办并跟进

  3. trimmy ↗

    找出旧规则与重复指令

  4. Stalk Bot ↗

    跟踪竞品网站与产品变化

  5. Explainer Video bot ↗

    整理材料并制作解说视频

  6. Bookmark Debt Collector ↗

    把书签整理成读、做、删的选择

  7. AI Radar ↗

    汇总 AI 动态并附原始链接

  8. Sentinel ↗

    监看漏洞与安全新闻

  9. Engineering Lead ↗

    分配开发任务并追踪检查

  10. akapen bot ↗

    先看方案、批注,再开始制作

↑ 返回目录
04

工作怎样重分配

岗位入口、公益股权与个人 Agent 的商业问题。

行业与人

效率增加之后,机会交给谁?

如果只统计省了多少时间,就会漏掉另两笔账:新人怎样学会工作,谁能分享技术带来的收益。

新人需要的,可能是另一种练习场

APPSO 对 Anthropic 内部工作的解读,是上期周日补记的另一篇文章,本期正式区间再次收录。它关注 AI 使用深入工作以后,初级岗位与培养方式会受到什么影响。这是对一家公司的材料和组织变化的讨论,不足以外推整个行业的招聘命运。02

但它提出的矛盾值得认真面对:如果检索、初稿与简单实现被自动化,年轻人少做的这些活,过去也恰好是熟悉业务、发现错误和接受反馈的入口。不能一面减少练手机会,一面要求新人直接拥有资深判断。

我的理解是,训练目标应从「独立写出第一版」扩展到「解释为什么这样写、找出它漏了什么、知道如何验证」。例如让新人先判断一个方案,再看模型结果;让他们保留自己的失败假设,与导师讨论差异。这样 AI 能提供更多练习样本,而不只是替人交卷。

公益基金的重点,是股权与分配规则

另一条新闻把 Anthropic 的公益基金写成了「捐 3200 亿分给普通人」。官方公告承诺的是股权安排:经股东批准后投入 5% 股份,并设定随估值变化、由董事会酌情追加的机制;面向特定人群的直接分配只是可能探索的方式之一。它不是已经到账的现金,也没有公布面向所有人的统一发放方案。08 官方公告

07 / 从承诺到收入

股权、基金与个人收入之间,还有几步
  1. 01股份承诺

    5% · 需股东批准

  2. 02基金治理与安排

    用途、受益对象、时间

  3. 03实际到达个人

    仍需具体方案与执行

第一项为官方承诺;后两项是兑现需要回答的问题,不代表已经执行。官方公告 ↗

这一步的意义,是开始讨论技术收益的所有权,而不只讨论谁用上了一个更便宜的工具。不过,股权承诺和社会保障之间还隔着治理、兑现时间、受益人选择与问责。对失去岗位的人来说,未来公司可能更值钱,并不等于今天就拥有可支配收入。

评价这类机制,后续应该看谁有资格、谁作决定、何时兑现、怎样公开结果。它也无法替代企业眼前该做的事:提供转岗训练、给新人保留学习入口,并让自动化的收益不只体现在少雇人上。

Agent 1.0、2.0 之外,用户愿意留下什么?

特工宇宙把 QClaw、元器等产品的调整,解释为从「搭 Agent 的平台」转向「直接替人工作的 Agent」。其中的「1.0 / 2.0」是文章的叙事框架,本刊也未独立确认文中全部下架时间。14

它仍然提供了一个有用的商业问题:用户究竟想拥有一个配置台,还是只想有一件事持续被做好?对开发者,编排能力可能是产品;对普通使用者,维护工作流常常只是额外劳动。

但界面更像助理,不会让持久记忆、失败恢复和可核对结果自动出现。真正值得跟踪的,是用户能否看懂它做过什么、能否带走数据、出错后能否接着做。产品换代的名字可以很快,信任仍然要靠这些小事积累。

↑ 返回目录
05

把过程留给自己

改一台 Kindle、做一个产品,以及重新找回好奇心。

本周余味

当终点变近了,还想走哪一段路?

一个人用 AI 找回折腾设备的乐趣,另一个人却因为一切太容易而失落。这两种感受,可以同时成立。

一台旧 Kindle,让「自己做」重新有趣

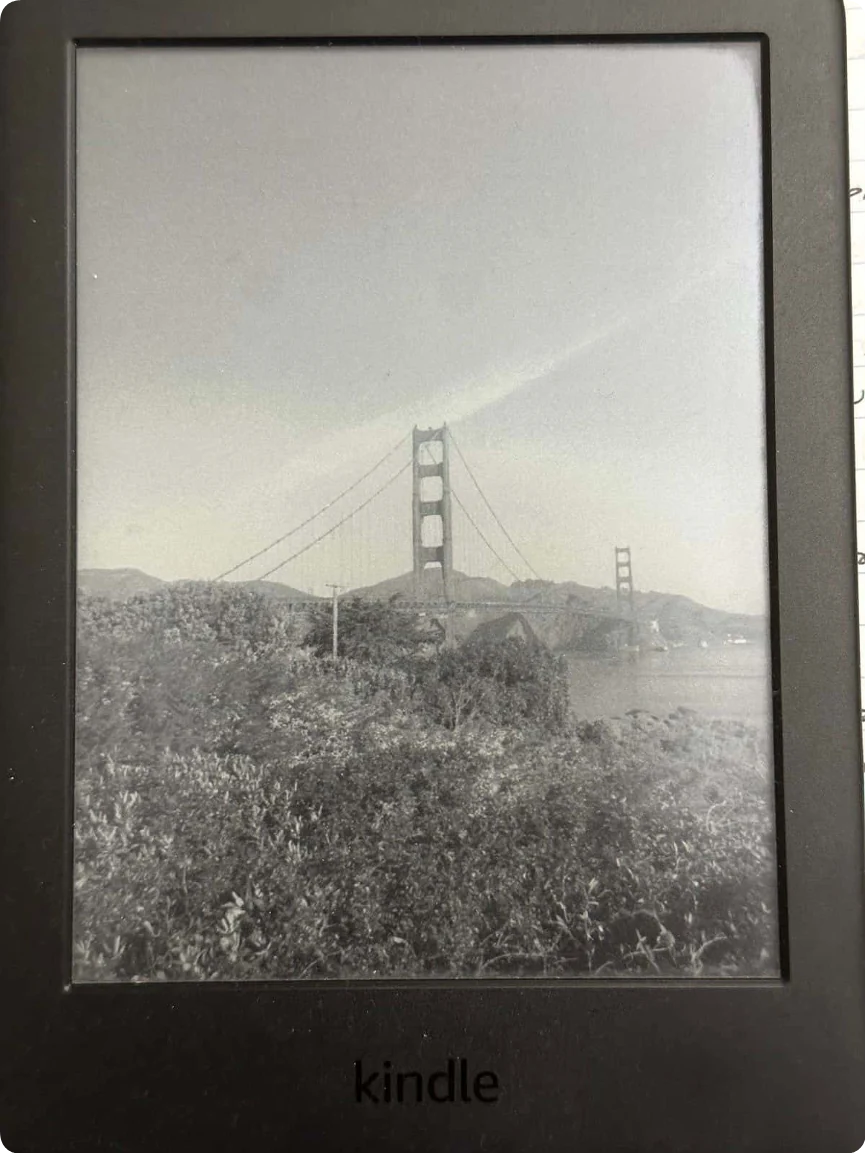
APPSO 的作者用 GPT-6 改造一台旧 Kindle,把它变成联网相框。文章的乐趣不在于自动生成了多少代码,而在于一块真实的墨水屏会给反馈:显示效果、刷新残影、网络与设备状态,都需要人拿在手里观察,再和 AI 一起调整。05

APPSO 原文中显示风景照片的 Kindle 墨水屏。

真实物件的反馈

屏幕不会因为代码跑通,就自动变好看。

画面、残影与刷新节奏,需要拿起设备才能判断。

图:APPSO 原文,保留完整比例 [05] ↗

这类小项目很适合作为 AI 的另一种使用方式:目标由自己挑,结果就在眼前,试错也可以只为好玩。模型降低了进入陌生领域的门槛,却没有替人决定为什么要做、什么样算满意。参与感不一定来自亲手敲每一行,它也来自发现问题、选择方案与看到真实物件改变。

一键通关之后,失落也不是矫情

卡兹克的文章写出了另一面:AI 让做产品与生成内容越来越轻松,他反而难以从中获得原来的快乐。文中借游戏开了修改器之后失去兴致的经历,描述一种目标还在、过程却被抽空的感觉;结尾没有声称解决了虚无,而是把注意力重新放在仍想探索的支线上。15

这不能推出「少用 AI 才能快乐」,也不能用「换个更大目标」敷衍过去。一个人可能珍惜作品完成后的效果,也可能珍惜学习一种手艺的过程。前一种满足可以因自动化扩大,后一种满足却可能被无意删掉。

给机器做减法,是减少无效负担;给自己留过程,是保留在乎的体验。 两者并不冲突。可以让 AI 搬运资料、定位报错,但把观察、试验和最后的判断留给自己。也可以专门留一个不以效率计价的项目,允许它慢,允许暂时没有用途。

08 / 留下什么

把重复交出去,把在乎的过程留下
可以交出去
重复搬运资料

搜索、转换、第一轮排错、机械检查。

可以留给自己
选择、体验与好奇

为什么做、真实感受、愿意再试一次的地方。

本期的阅读联想,不是关于幸福或心理状态的研究结论。[05][15]

光环不会替你理解用户

地心引力这封短通讯收了法国与中美模式的文章、播客,也提到「字节掘金者:最贵的是光环」。与本期相关的,是它对应用创业的提醒:漂亮履历和资本投入,无法保证做出让人愿意使用的产品。04

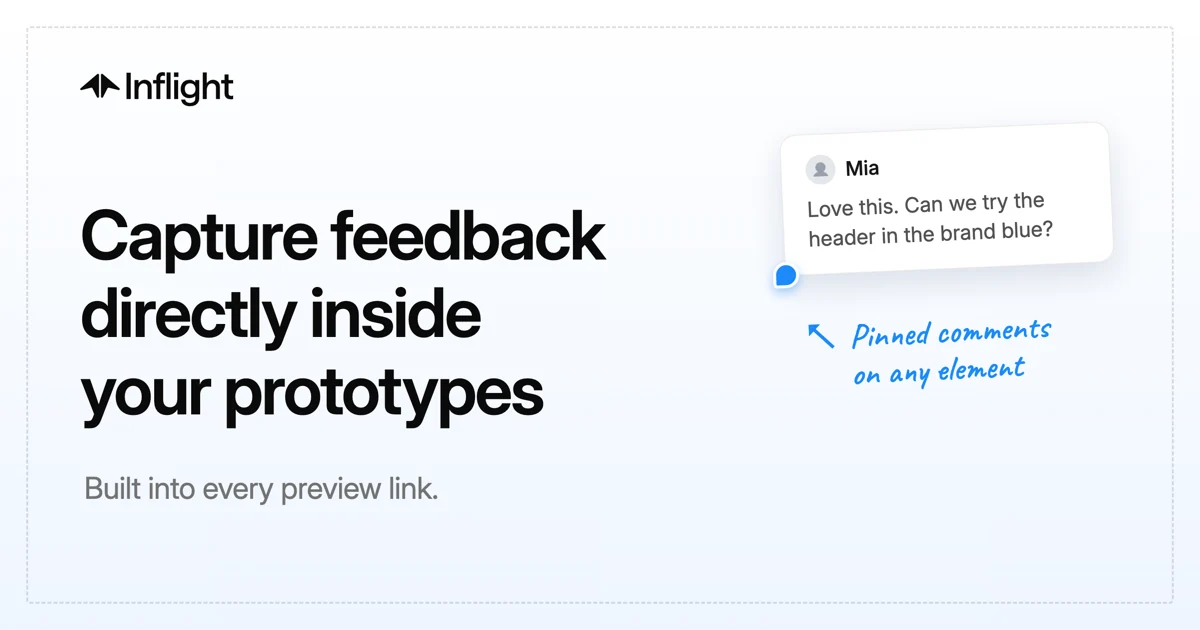
这与 DEX #368 对软件越来越好做、协作却未必更容易的感慨,以及 AIGC #193 收录的 Linear 产品文章,形成了一个回声:制造能力正在普及,理解具体的人、持续作出取舍,仍然需要有人在场。11 12

所以这期最后想留下的,不是「再装一个更聪明的 Agent」。先找一件愿意反复观察、愿意承担结果的小事,把机器可以接手的重复劳动交出去,再看自己是否更靠近了它。那才是减法带来的空间。

↑ 返回目录
完整阅读目录17 / 17

按新加坡时间的收藏日期划定范围,涵盖 10 月 18–24 日全部 17 条可见记录。01、02 已在上期周日补记出现,本期保留衔接。阅读全文缓存后编写,并核对可取得的研究与官方公告;社区案例未独立复测。三封邮件没有公开原文地址,AIGC #193 的保存副本提示可能存在源侧截断。

  1. 01

    别只盯着AI Coding,真正的变化发生在整个研发流程

    腾讯技术工程(微信公众号)· danteyang · 2026-10-18 · 与 004 期衔接

  2. 02

    看完Anthropic内部工作报告,真替应届生捏把汗

    APPSO(微信公众号) · 2026-10-18 · 与 004 期衔接

  3. 03

    离谱:Hugging Face 史上点赞第 10 的模型,94% 来自新注册账号

    尹John · AGI Hunt(微信公众号) · 2026-10-18

  4. 04

    短更新:What’s the Matter With France?

    地心引力(Newsletter · walnut@hedwig.pub) · 2026-10-18

    阅读流记录 ↗已保存邮件 · 无公开链接本期讨论 ↗
  5. 05

    用 GPT-6 魔改 Kindle,我又找到了越狱的乐趣

    APPSO(微信公众号) · 2026-10-19

  6. 06

    AI生成的代码看不懂就扔掉重来:一位首席架构师的 5 条 Agent 编程反常识原则

    林绮蓓、蔡芳芳 · InfoQ(微信公众号) · 2026-10-19

  7. 07

    哈佛谷歌惊人研究:GPT-6 Astra已解决98%世界物理难题!

    Aeneas 大卫 · 新智元(微信公众号) · 2026-10-19

  8. 08

    刚刚,Anthropic官宣!要捐3200亿分给普通人

    摩西 桃子 · 新智元(微信公众号) · 2026-10-19

  9. 09

    Pi Durable 出了原生苹果 App:Apple Bots 一周进展(@xiaomovps)

    小墨同学 (@xiaomovps) · 2026-10-19

  10. 10

    实测 Lovart 2.0 ,设计 AI 进入个人助理时代

    APPSO(微信公众号) · 2026-10-19

  11. 11

    AIGC Weekly #193:Meta Muse / Anthropic 公益基金 / DeepSeek V4.1(歸藏 Newsletter)

    歸藏 / AIGC Weekly · 2026-10-20

    阅读流记录 ↗已保存邮件 · 无公开链接本期讨论 ↗
  12. 12

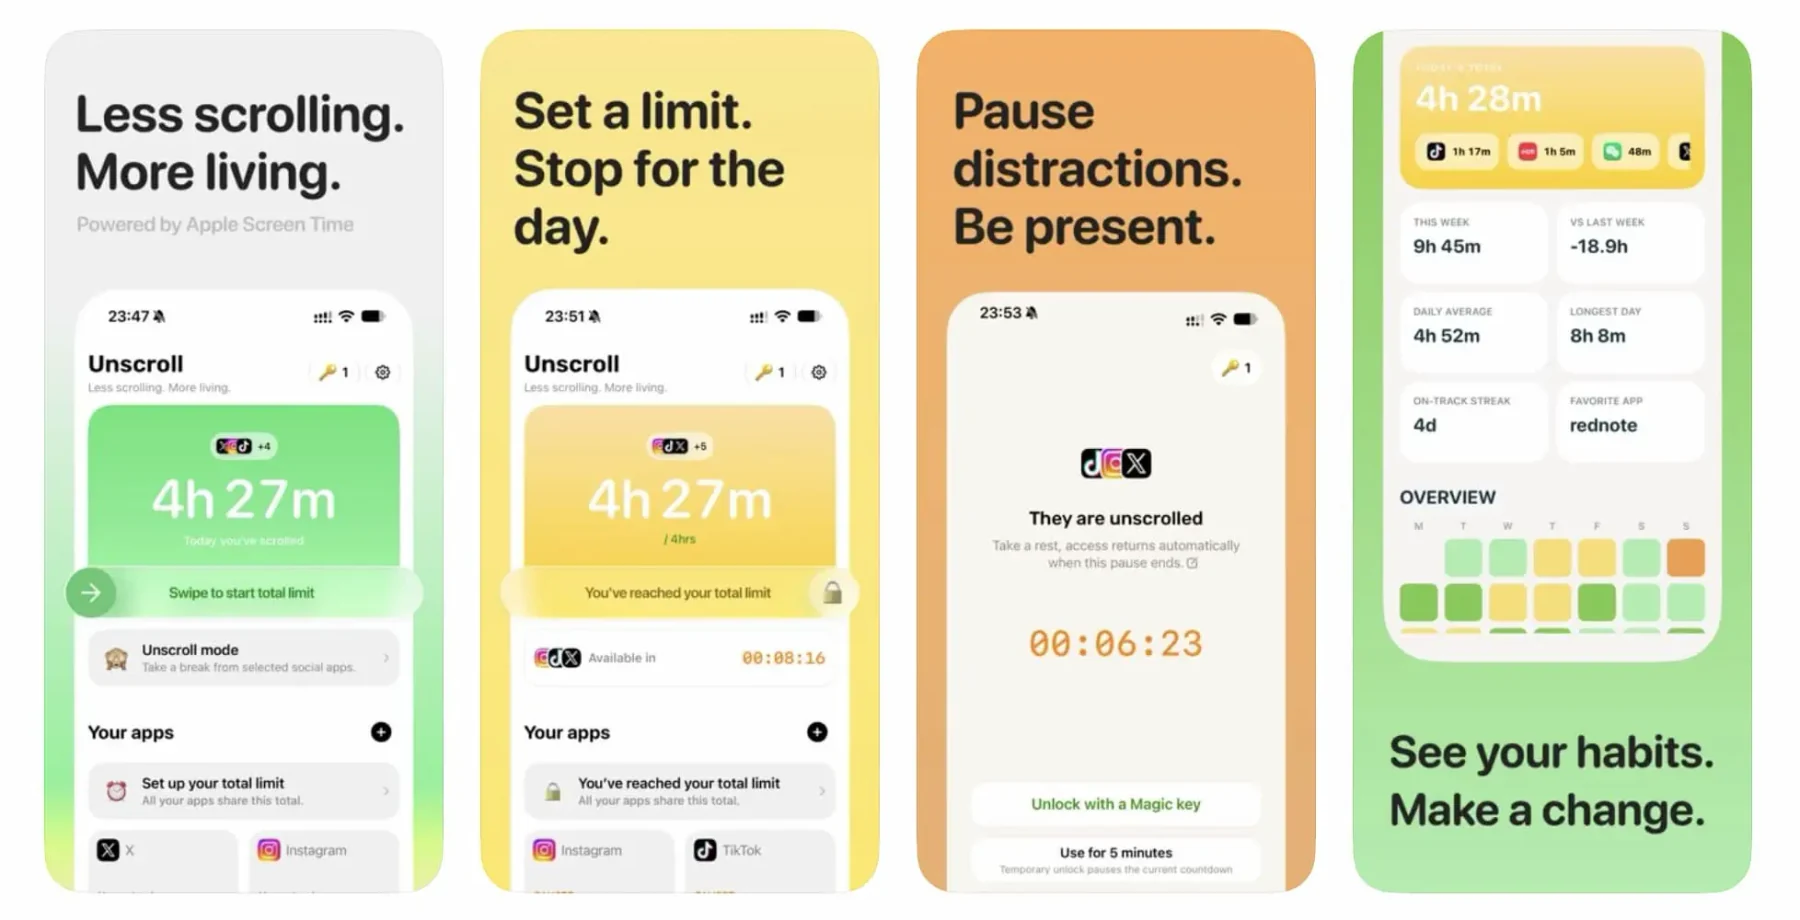
    DEX 周刊 · #368 Unscroll

    dingyi / DEX 周刊 · 2026-10-20

    阅读流记录 ↗已保存邮件 · 无公开链接本期讨论 ↗
  13. 13

    给AI写了800行规则,它反而更不听话了

    刘俊毅 / 腾讯云开发者 · 2026-10-21

  14. 14

    腾讯 QClaw、元器下架:Agent 1.0 落幕,Agent 2.0 时代到来

    宇宙编辑部 / 特工宇宙 · 2026-10-22

  15. 15

    我好像陷入了某种,AI时代的虚无主义。

    数字生命卡兹克 · 2026-10-23

  16. 16

    Anthropic:谨慎使用子 Agent

    Diane Sarkis / AGI Hunt · 2026-10-23

  17. 17

    至高の Grok Bot 10選(@cu30rry_)

    kaito (@cu30rry_) · 2026-10-24

读完这一期,还有下一期

把一周的 AI 阅读,寄给你。

每周一更新。可选中文或英文,封面、主题导读与全部阅读入口,每期一封。

周刊 RSS ↗

和朋友一起读

分享这一期

AI 趋势周刊 005 · 给 Agent 做减法

可保存封面图片,发给一起阅读的朋友。

Follow what matters

订阅 Airing

选择接收方式,再决定你真正想看的内容。

新一期编好后发送;周刊邮件中可切换语言或退订。