封面专题
AI 交出 700 多份手稿,数学家为何分歧如此之大?
10 月 6 日,OpenAI 公布内部模型生成的数学研究材料。有人把它看作科研加速的起点,有人呼吁停止合作。这两种反应,究竟在回答什么问题?
本期重点读卡兹克《AI让数学再也回不去那个旧世界了。》,再对照 APPSO 的争议报道与数学家的原始声明。从事件本身开始,看看 AI 改变了哪一段研究,又把哪些问题推到了台前。
10 月 6 日,究竟发生了什么?
10 月 6 日,OpenAI 在 GitHub 建立 openai/math 仓库,公开了一批由未发布的内部模型生成的数学手稿与证明材料。事情的起点,是公司现有的数学评测越来越难区分模型水平,于是把测试推进到尚未解决的研究问题上。对普通读者来说,最重要的变化是:AI 交出的开始包含对未知问题的论证,而不只是标准题的答案。
“数学手稿”可以先理解为研究论文的草稿:它要明确声称什么成立,列出成立的条件,再给出推导。公开草稿便于别人检查、讨论和接着研究,却不等于已经完成同行评审。仓库中的材料有不同的核验进度,也包含同一主结果的补充证明、推论或另一种证法,所以文件数不能直接当作突破的数量。
BACKGROUND / THE RELEASE AND RESPONSE
先把这件事放回时间线
发布之前,已有分歧
独立学者咨询小组 AGMAI 发布建议,关注研究自主与成果消化。
OpenAI 公开数学手稿
内部模型尝试开放问题;公开材料供外界检查。
修正错误,争议扩大
仓库记录 3 份撤回;人类数学协会 AHM 发布抵制声明。
719 份手稿覆盖 372 个问题家族;同一家族可以有不止一份手稿。
数量依据本期核对的仓库版本。“手稿”“独立问题”和“同行评审论文”不是同一个计量单位;未形式化也不等于已被证伪。
其中引人注目的方向包括:研究素数分布背后的黎曼 ζ 函数、寻找更快的矩阵乘法,以及四维空间中的挂谷问题。即使不掌握这些数学细节,也能理解它们为何引起关注:模型正在尝试研究者长期追踪的问题,给出的材料有机会被逐步核查,而非只能凭语言流畅度来相信。
发布也很快伴随纠错。最初的 722 份手稿,在三份撤回后变为本期采用版本的 719 份,仍归在 372 个成果家族中。乐观者看到的是机器探索的规模;谨慎者看到的是大量研究材料仍待审查。接下来的争论,正是从这两种观察同时成立开始的。
三个数学结果,分别说明什么?可选背景 · 范围、图解与原手稿
想进一步了解这三个问题,可以从下面的入门图解读起。图中解释手稿报告的结论与范围,完整证明仍需查阅原文。
准黎曼:固定的零点边界
主手稿报告 7/8 右侧的无零点结论,并有同家族的 11/12 伴随证明。它们不等于完整黎曼猜想。这个例子的意义,是 AI 提供了可追查的研究论证;该论证能否完全成立,仍要按具体命题与证明来核验。
01 / A BOUNDARY IN THE COMPLEX PLANE
7/8 的边界,还没有到 1/2
s = σ + it。横轴是实部,纵轴是虚部;高度不限。图中没有采样零点。
- 1/2
- 黎曼猜想的目标ζ(s) 的非平凡零点都在这条线上。
- 7/8
- 主证明的固定边界声明 Re(s) > 7/8 没有零点;主函数在 s=1 的极点另行处理。
- 11/12
- 另一份证明的边界属于同一成果家族,边界更靠右。两份证明的常数不要混用。
矩阵乘法:指数上界,不是训练速度
手稿报告复数域的指数上界 9/4,并保留任意正 ε 的条件。下图只比较渐近主导项的增长;不能从 4.76 倍增长因子,推导出某张显卡或某个模型的实测加速。
02 / COMPUTATION GROWTH
不是少算一个格子,而是改造整块乘法的算法
c₁₁ = a₁₁b₁₁ + a₁₂b₂₁
逐项算 4 个格子,需要 8 次标量乘法。Strassen 将块乘法重组为 7 次,并递归使用。
矩阵边长翻倍,主导计算量乘几倍?
编者的渐近增长示意:比较 2^ω,忽略常数与 ε;不是实测速度,也不表示小矩阵更快。
原手稿 / 定理 1.1 的准确口径
放大原图 ↗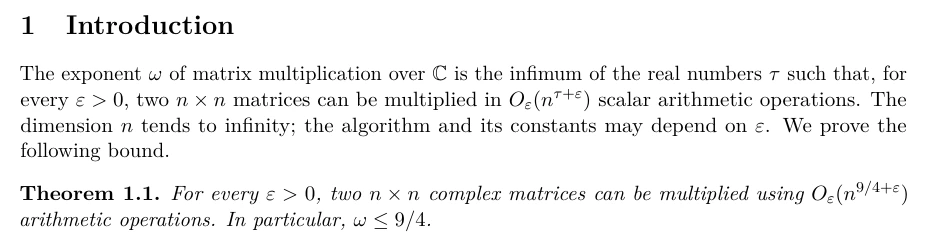
四维挂谷:维数与体积是不同指标
手稿报告四维空间中含各方向单位线段的集合具有完整 Hausdorff 维数。二维方向图只是入门示意,不展示四维证明,也不能用来宣布集合必须具有正体积。
03 / DIRECTIONS AND DIMENSION
“每个方向都有”,约束的是整个集合
二维方向示意。真正的条件允许线段各自平移,不要求经过同一个中心;此图不展示四维证明。
维数在问:细看时,需要多少空间来容纳它?
R⁴ → dimH = 4四维手稿的声明:只要每个方向都有一条单位线段,Hausdorff 维数就不能降到 4 以下。
这些是维数的直觉例子。满 Hausdorff 维数不等于正的体积;度量与命题口径要分开。
为什么这次值得重视:AI 开始提供研究路径
过去谈 AI 做数学,常见场景是让它解一道已有答案的题,或把人写好的证明翻译成机器能检查的形式。开放问题没有随手可查的标准答案:系统需要找到可行的论证、处理障碍,并把结果写成别人能追问的材料。若这些论证成立,这就是研究能力的进展,不能因为作者是机器就抹去。
卡兹克那篇文章最有启发的一点,是把这种进展与反馈速度联系起来。在可以较快检验结果的领域,AI 能反复尝试、发现失败、改变路线;同样一段时间里,可探索的方向就可能增加。这个想法也解释了为什么数学与代码特别受关注:它们的一部分成果,能够接上自动检查。
CAPABILITY / A RESEARCH PATH
AI 的作用,可以沿一条研究路径来看
一个尚未解决的问题
现有文献、定义与限制条件
引理B
反例C
新路径
把尝试变成候选论证
- 推导是否成立
- 与已有结果是什么关系
- 别人能否理解与复用
反例、检查结果和新理解,继续改变下一轮探索。
研究过程示意,A/B/C 不代表此次实验的实际分支数。AI 可以参与探索、核验和解释;这幅图不规定人与 AI 的永久分工。
但这里仍有一处需要补上:找到证明、把它写入形式系统、确认它对应原问题,是不同的工作。仓库发布的是一套评估与整理流程留下的成果。模型承担了实质性的论证生成,问题选择、既有文献、检查工具和发布筛选也参与其中。承认 AI 的贡献,与看见这些条件,并不冲突。
真正令人兴奋的前景,是研究者可以让模型探索自己暂时顾不过来的路径,再从中提炼有用的方法。变化因此不只是“一道题更快做完”,还可能是同一个人有能力比较更多方向。当然,公开的成功材料还不足以告诉我们,随便换一个研究问题,系统有多大把握成功。
反对者究竟在反对什么?
APPSO 收藏文章《陶哲轩转发抵制声明,数学界和 OpenAI 彻底撕破脸》把另一面带进了视野:手稿中的错误、批量发布的方式,以及研究者对未来角色的担忧。它与卡兹克文章形成的张力很清楚——前者追问这次发布怎样影响数学共同体,后者更看重 AI 能力跃迁带来的可能性。两篇都比各自标题呈现的立场复杂。
这里需要先认识两个名字。人类数学协会(AHM)在 10 月 7 日明确呼吁数学家停止与 OpenAI 合作,认为这类发布把公司力量放在了理解数学之前。数学与人工智能咨询小组(AGMAI)则由一组独立学者组成:他们也反对用外界无法使用的内部模型测试前沿问题,但继续与实验室沟通,并提出公开、解释和资源支持的要求。
DEBATE / THE DIFFERENT CLAIMS
同一批手稿,三种不同的关注点
OpenAI
手稿发布方
核心判断用尚未解决的数学问题,检验内部模型的研究能力。
行动开放手稿与部分研究轨迹,让外界检查结果。
AHM
人类数学协会
核心判断批量生成证明,不等于数学共同体获得了理解。
行动呼吁停止与 OpenAI 合作,主张科研以人的理解为中心。
AGMAI
数学与人工智能咨询小组
核心判断工具可及、研究自主与共同体消化成果的能力,都应进入评价。
行动建议停止在专有模型上测试高等数学,并通过独立机构资助共同体消化工作。
依据各方一手声明概括。AGMAI 提供建议不等于为发布背书;陶哲轩博客刊载 AHM 客座文章,不等于他代表全体数学家发言。
因此,“数学界抵制 AI”会把不同意见压成一种。陶哲轩博客转载的是 AHM 署名的客座声明;转载本身不等于由他领衔起草。AGMAI 提供建议,也不等于给这批成果背书。读到这些名字时,应当追问具体是谁、针对哪件事、提出什么要求。
APPSO 提到的撤回是实际的质量警讯,应该影响我们对未检查材料的信任;它却不是所有成果均被推翻的证据。同样,某份证明最终成立,也不能反过来证明发布与合作方式毫无问题。双方真正交叉的地方,是技术进展已经开始改变研究者的工作,而怎样衡量、怎样共同承担这种改变,还没有形成共识。
有了 Lean,为什么争论还没有结束?
先把 Lean 想成一种把数学定义、命题与证明写得足够精确的语言。它的证明内核负责检查:在给定假设下,这段推导是否符合规则。它的重要性在于,读者不用仅凭“作者说自己检查过”来建立信任,也可以运行对应的检查。
然而,检查通过回答的是“写进去的命题是否得到证明”。举一个入门例子:想证明“所有整数的平方都大于零”,却在代码里多加了“这个整数不等于零”的条件,后一个命题能够成立,原来那个命题却在零这里失败。机器没有失职;被检查的任务已经变了。实际研究中的差异会更隐蔽,因此原问题、自然语言手稿与形式化命题仍须逐项对应。
WORKED EXAMPLE / CHECK THE STATEMENT
多加一个条件,证明可能对了,问题却变了
∀ n ∈ ℤ, n² > 0
所有整数的平方都大于 0。
∀ n ∈ ℤ, n ≠ 0 ⇒ n² > 0
所有非零整数的平方都大于 0。
编者设计的入门例子,不是这次手稿的错误案例,也不是 Lean 代码或运行结果。形式核验检查被编码的命题;我们仍要核对编码是否忠实表达了原问题。
此外,一个证明即便正确,也可能重新发现了已有结论,或暂时没有让人看清方法。卡兹克把自动检查视为科研加速器,这一点值得重视;把整个科研过程的判断成本都算成一次检查的成本,就会低估文献核对、解释和应用所需的工作。形式化覆盖到哪一步,也必须具体说明。
这些工作并不注定永远只能靠人慢慢完成。Lean 内核的一份缺陷复盘已经记录了 AI 辅助查错的作用,模型也可以帮助搜索文献、比较命题和寻找反例。更合理的技术路线,是同时改进生成与检查,让“这份材料为什么可信”能够被下一位研究者直接利用。
证明便宜了,谁来承担理解的工作?
设想一位研究生准备花几个月研究一个问题,突然发现 AI 已经公开了一份可能的证明。对学科来说,这或许是好消息;对他来说,原来的研究计划却要重排。他需要先确认结果,再决定改换方向、扩展结论,还是把证明中的新方法学会。得到答案和获得研究能力,并不发生在同一个瞬间。
这个场景解释了为什么“多发些成果总是好事”不足以结束争论。研究成果要通过讲解、讨论与使用,才能进入其他人的工作。若产出量增长得比消化能力快,注意力就会转向筛选和理解:哪些值得先读,谁来解释,做这些工作的人能获得什么支持与认可?
ACCESS / WHAT REACHES THE COMMUNITY?
能读到成果,与能使用研究工具,是两种机会
大家可以检查结果,但不一定有条件发起同样的探索。
工具、资源与学术认可,使研究者能继续选题、理解和训练下一代。
编者概括的两种研究条件,不是对工具开放程度或研究成本的定量测量。
AGMAI 提出的一条具体办法,是让发布大量尚未被充分理解材料的实验室支持后续工作,并由既有的非营利学术机构决定资源怎样分配。研讨会、长期工作组、面向学生的讲解,都可以成为研究成果的一部分。这个建议的要点,是把“发布一个答案”与“帮助学科使用这个答案”连起来。
另一层问题是工具能否被广泛使用。公开一份证明,让别人能够核查;开放研究工具,让别人能够按自己的兴趣提出问题。两者都重要,作用却不同。我担心的未来是少数实验室不断出题、交卷,其他人只能接收;我更希望看到的,是更多研究者借助同类能力开展自己选择的探索。
艺术家曾经抵制 AI,这次会重演吗?
这种联想很自然:一个群体长期投入的专业能力,突然面对大规模自动化;一部分人兴奋,另一部分人担心职业与价值被削弱。艺术家与数学家都可能有这种感受。但要判断两场争议是否相似,不能只看“有人反对”,还要看他们反对的对象后来发生了什么变化。
先看更贴近数学的先例。1976 年,Appel 与 Haken 的四色定理证明使用计算机处理大量情形。四色定理说的是:平面地图只需四种颜色,就能让共享边界的地区颜色不同。争论不仅是程序会不会出错,也包括一个人无法逐项读完的计算,能否带来与传统证明相同的理解。Thurston 在 1994 年仍借它讨论数学中的理解;2005 年完成的形式化证明,则加强了可靠检查的基础。后来形成的是新的检查方法与信任方式,解释的需求并没有消失。
HISTORY / WHAT ACTUALLY CHANGED?
历史里的变化,发生在核验方法和合作条件上
数学:怎样相信机器参与的证明?
- 计算机辅助证明
四色定理的证明依赖大量机器检查,引出可靠性与理解的讨论。
- 理解也是研究成果
Thurston 讨论证明如何帮助数学家传播理解。
- 加入形式化核验
Gonthier 的形式化证明进一步建立可由机器检查的依据。
后续进展增加了核验方法,也继续追问如何理解。
这次有什么不同这次 AI 还在生成研究论证;大量产出、专有工具和研究机会的分配,是额外的问题。
创作:谁的作品训练了模型?
- 反对未经许可的训练
创作者联署关注作品被使用的许可,以及创作者的生计。
- 部分合作开始谈条件
WMG 与 Suno 宣布许可合作,包含创作者选择是否参与的安排。
技术采用与争取许可、报酬和选择权,可以同时发生。
这次有什么不同一项合作公告不代表所有创作者受益;艺术价值也不能像数学命题一样接受真假检验。
资料:Thurston、Gonthier、2024 训练声明与 WMG 公告。按事件先后排列;不表示时间间隔或必然走向。
再看艺术领域。2024 年创作者的 AI 训练声明,针对的是未经授权使用作品。它提出的问题并不是“机器永远画不好”,而是作品如何被使用,以及创作者的生计。2025 年,华纳音乐与 Suno 宣布许可合作,强调相关使用中的创作者选择权。这个后续说明,采用 AI 与谈判合作条件可以同时发生;它并不能说明所有艺术家已经受益,或者早先的反对都失去了理由。
回到数学,结论的真假有相对严格的检查方法,艺术价值却没有同一种裁判;今天的 AI 还直接参与生成研究路线,影响也超出了早年的计算机辅助证明。可以借鉴的不是一条“先反对、后接受”的宿命,而是一种更具体的转变:把担忧落实为可检查的证明、可使用的工具、可讨论的署名与可持续的培养方式。
数学家与 AI,怎样合作才不只剩“交卷与批卷”?
把未来想成“AI 不断写证明,人类负责审核”,容易忽略研究的循环。一个证明会带出新的问题,失败的路线也可能留下方法;模型既可以帮忙找答案,也可以帮助提出问题、比较解释。因此,把“提问与意义永远属于人,执行永远属于机器”当作稳定分工,同样不可靠。
更有建设性的关系可以从一个具体研究任务出发:研究者说明想理解的现象,模型列出可能的路线;双方通过小例子、反例与文献排除不合适的方向;形成论证后,再把关键思路与检查材料整理成别人能用的形式。这里每一步都允许 AI 参与,也要求贡献能够被追问,而不是用一份看似完整的输出替代整个过程。
RELATIONSHIP / KEEP THE LOOP OPEN
成果要回到下一轮研究里
- 01→
提出一个值得追问的问题
人和 AI 都可以提出候选;交代为什么值得研究。
- 02↓
生成论证,也寻找反例
并行尝试引理、计算案例与不同证明路线。
- 03←
核验并讲清贡献
检查推导、原命题、已有工作和方法的适用范围。
- 04↑
让别人能接着研究
分享解释、工具与失败经验,形成下一轮问题。
理解、工具与人的成长,成为新问题的起点。
编者提出的合作方式:人和 AI 可以参与各阶段。它能否形成,取决于工具可及、研究资源和学术评价,而不只取决于模型能解多少题。
对学生,最需要保护的也许是练习判断的机会。我的建议是,允许用模型比较路线、检索背景,但要求学生解释关键假设,指出一个失败例子,并在条件改变后重新推理。这样才能区分“拿到了证明”与“学会了做研究”。Grant Sanderson 关于奖励解释工作的文章,以及 Álvaro Lozano-Robledo 对学生处境的讨论,都把注意力带向了这种能力的培养。
这还需要评价方式配合。如果学术奖励只认新结论的数量,写出清楚解释、整理机器证明、帮助别人掌握新方法,就容易成为没有回报的附属劳动。研究工具的进步应当扩大这些工作能够产生的价值。否则,即使成果更多,参与者也可能更难获得独立成长的空间。
跨过解题门槛之后,还有一道共同研究的门槛
我推荐卡兹克那篇文章,是因为它让人看到:AI 的作用正在从辅助阅读和解题,延伸到研究成果的产生。这个变化值得兴奋,也值得逐项验证。APPSO 和数学家的声明补上了另一半:科研进展要通过人的讨论、工具的开放与方法的传播,才能真正扩展一个学科的能力。
所以,我不会把这场分歧写成“数学家输不起”,也不会据此宣布 AI 不该参与研究。我更看好持续合作,同时把解释、核查与资源支持放进成果发布的安排。机器能够贡献新的思想;研究者也应有条件检查它、改变它,并用它提出自己的问题。
接下来最值得观察的,是这些手稿有没有被独立复查、有没有催生新的研究,以及学生和普通研究者能否获得相应工具。它们会告诉我们,这次发布带来的究竟主要是更多文件,还是更多人能够继续探索的知识。下面几篇 Agent 专题,也沿着这条线展开:能力如何进入一项能够持续完成、能够回头检查的工作。